Compare commits
37
Commits
f94e8e3dcd
...
main
| Author | SHA1 | Date | |
|---|---|---|---|
 hanyixuanten |
6fde967ca1 | ||
|
hanyixuanten
|
9c18114c70 | ||
|
hanyixuanten
|
a9ab81ba6b | ||
|
hanyixuanten
|
8453dca92e | ||
|
hanyixuanten
|
6852bea34c | ||
|
hanyixuanten
|
c5eebf5252 | ||
|
hanyixuanten
|
8e1bfd9d9e | ||
|
hanyixuanten
|
4b50c059cd | ||
|
hanyixuanten
|
ad876116a5 | ||
|
hanyixuanten
|
209d5715a5 | ||
|
hanyixuanten
|
bde443aa2e | ||
|
hanyixuanten
|
47e9acfb6a | ||
|
hanyixuanten
|
ed0d5cf6e7 | ||
|
hanyixuanten
|
2e796fa148 | ||
|
hanyixuanten
|
2fd0baf3ab | ||
|
hanyixuanten
|
cfd4039a68 | ||
|
hanyixuanten
|
399e5e031a | ||
|
hanyixuanten
|
1dedc9f79d | ||
|
hanyixuanten
|
3b54c62830 | ||
|
hanyixuanten
|
9a99b60552 | ||
|
hanyixuanten
|
43d9b98755 | ||
|
hanyixuanten
|
dc65d1feb2 | ||
|
hanyixuanten
|
a92069d382 | ||
|
hanyixuanten
|
54aa7ffc70 | ||
|
hanyixuanten
|
2b981db24d | ||
|
hanyixuanten
|
143cede06f | ||
|
hanyixuanten
|
0698b03d94 | ||
|
hanyixuanten
|
6dd6508386 | ||
|
hanyixuanten
|
9cb32e82c0 | ||
|
hanyixuanten
|
5b2f051c11 | ||
|
hanyixuanten
|
77c65b3f80 | ||
|
hanyixuanten
|
c0f663fbe5 | ||
|
hanyixuanten
|
8c1dfb5d0c | ||
|
hanyixuanten
|
c89b0d349f | ||
|
hanyixuanten
|
095dcf1eac | ||
|
hanyixuanten
|
1d59a2d3f1 | ||
|
hanyixuanten
|
6e8778f275 |
No files matched your search
@@ -3,7 +3,7 @@ name: Sync solutions to Wiki
|
||||
|
||||
on:
|
||||
push:
|
||||
branches: [master]
|
||||
branches: [main]
|
||||
paths:
|
||||
- "solutions/**"
|
||||
- ".gitea/workflows/sync-wiki.yml"
|
||||
@@ -73,10 +73,11 @@ jobs:
|
||||
out=wiki/_Sidebar.md
|
||||
|
||||
# 收集 solutions 下所有 md(相对路径,去掉扩展名),按路径排序
|
||||
# 用 -V 做自然排序:P1000 < P2000 < P10000,而不是字典序的 P10000 < P2000
|
||||
mapfile -t items < <(
|
||||
find solutions -type f -name '*.md' -printf '%P\n' \
|
||||
| sed 's/\.md$//' \
|
||||
| sort
|
||||
| sort -V
|
||||
)
|
||||
|
||||
{
|
||||
|
||||
+3
-1
@@ -8,4 +8,6 @@
|
||||
!*.md
|
||||
!.gitea
|
||||
!.gitea/**
|
||||
!.clang-format
|
||||
!.clang-format
|
||||
!article
|
||||
!article/*.md
|
||||
+79
@@ -0,0 +1,79 @@
|
||||
#include <bits/stdc++.h>
|
||||
using namespace std;
|
||||
int n, m, k;
|
||||
long long x, y;
|
||||
int a[200005];
|
||||
int b, preb;
|
||||
int pos[200005];
|
||||
bool k_is_better;
|
||||
vector<int> mor;
|
||||
long long del(int pre, int todo)
|
||||
{
|
||||
if (todo <= pre)
|
||||
return -1;
|
||||
if (todo == pre + 1)
|
||||
return 0;
|
||||
mor.clear();
|
||||
for (int j = pre + 1; j <= todo - 1; ++j)
|
||||
if (a[j] > max(a[todo], a[pre]))
|
||||
mor.push_back(j);
|
||||
if (!mor.empty() && (todo - pre - 1) < k) // 如果有大数且长度不足以运行一次 k 则不存在
|
||||
return -1;
|
||||
if (k_is_better)
|
||||
{
|
||||
return ((todo - pre - 1) % k) * y + ((todo - pre - 1) / k) * x; // 先用 y 移除多余的数,最后用多个 k 直接删完
|
||||
}
|
||||
else
|
||||
{
|
||||
if (!mor.empty())
|
||||
return (todo - pre - 1 - k) * y + x; // 用一次k清除最大数,其余用y
|
||||
else
|
||||
return (todo - pre - 1) * y; // 全部用y
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
int main()
|
||||
{
|
||||
scanf("%d%d%lld%d%lld", &n, &m, &x, &k, &y);
|
||||
k_is_better = x < (k * y);
|
||||
for (int i = 1; i <= n; ++i)
|
||||
{
|
||||
scanf("%d", &a[i]);
|
||||
pos[a[i]] = i;
|
||||
}
|
||||
long long ans = 0;
|
||||
for (int i = 1; i <= m; ++i)
|
||||
{
|
||||
scanf("%d", &b);
|
||||
int todo = pos[b], pre = 0;
|
||||
if (i != 1)
|
||||
pre = pos[preb];
|
||||
long long d = del(pre, todo);
|
||||
if (d == -1ll)
|
||||
{
|
||||
printf("-1\n");
|
||||
return 0;
|
||||
}
|
||||
ans += d;
|
||||
preb = b;
|
||||
}
|
||||
long long d = del(pos[b], n + 1);
|
||||
if (d == -1ll)
|
||||
{
|
||||
printf("-1\n");
|
||||
return 0;
|
||||
}
|
||||
printf("%lld\n", ans + d);
|
||||
return 0;
|
||||
}
|
||||
/*
|
||||
若 k 删除更优,先删到能被 k 整除的长度,则先 k 删除,最后运行多次 k 删除
|
||||
len % k
|
||||
若 1 删除更优,先用 k 删除删去大于两边的,最后用 1 删除
|
||||
7 2
|
||||
3 3 1
|
||||
5 7 0 3 1 6 4
|
||||
5 4
|
||||
|
||||
输出 5
|
||||
*/
|
||||
+80
@@ -0,0 +1,80 @@
|
||||
# CF1380D Berserk And Fireball
|
||||
|
||||
## 题目描述
|
||||
|
||||
有 $n$ 个战士站成一排,第 $i$ 个战士的战力是 $a_i$。所有战士的战力都是两两不同的。
|
||||
|
||||
你可以使用两种类型的咒语:
|
||||
|
||||
1. 火球术:你可以消耗 $x$ 点法力值来干掉连续的 $k$ 个战士(你必须干掉正好 $k$ 个,而不能干掉 $\le k$ 个)。
|
||||
|
||||
2. 狂暴术:你可以消耗 $y$ 点法力值,选择站在一起的两个战士使他们展开决斗,战力较弱的那个战士将会被干掉。
|
||||
|
||||
我们来举个例子,假设有 $7$ 个战士,其战力分别为 $[2,3,7,8,11,5,4]$,且此时的$k=3$($k$ 的定义详见火球术)。如果你对战力为 $8$ 与 $11$ 的两个战士施加狂暴术,剩下战士的战力将会变成 $[2,3,7,11,5,4]$(战力为 $8$ 的战士在决斗中战死)。然后如果我们对战力为 $[7,11,5]$ 的战士施加火球术,剩下战士的战力将会变成 $[2,3,4]$。
|
||||
|
||||
你想要组建一支军队,因此你想要将所有战士战力的序列从 $a_1,a_2,\cdots,a_n$ 变为 $b_1,b_2,\cdots,b_m$。试计算你所需的最少法力值。
|
||||
|
||||
## 输入格式
|
||||
|
||||
第一行两个整数 $n,m (1\le n,m\le 2\cdot 10^5)$ ——序列 $a$ 的长度和序列 $b$ 的长度。
|
||||
|
||||
第二行三个整数 $x,k,y (1\le x,y\le 10^9,1\le k\le n)$ ——火球术消耗的法力值,火球术的范围和狂暴术消耗的法力值。
|
||||
|
||||
第三行 $n$ 个整数 $a_1,a_2,…,a_n (1\le a_i\le n)$。保证 $a_i$ 是两两不同的。
|
||||
|
||||
第四行 $m$ 个整数 $b_1,b_2,…,b_m(1\le b_i\le n)$。保证 $b_i$ 是两两不同的。
|
||||
|
||||
## 输出格式
|
||||
|
||||
一行一个整数,即将序列从 $a_1,a_2,\cdots,a_n$ 变为 $b_1,b_2,\cdots,b_m$所需的最少法力值。如果无法完成变换,则输出$-1$。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
5 2
|
||||
5 2 3
|
||||
3 1 4 5 2
|
||||
3 5
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
8
|
||||
```
|
||||
|
||||
## 输入输出样例 #2
|
||||
|
||||
### 输入 #2
|
||||
|
||||
```
|
||||
4 4
|
||||
5 1 4
|
||||
4 3 1 2
|
||||
2 4 3 1
|
||||
```
|
||||
|
||||
### 输出 #2
|
||||
|
||||
```
|
||||
-1
|
||||
```
|
||||
|
||||
## 输入输出样例 #3
|
||||
|
||||
### 输入 #3
|
||||
|
||||
```
|
||||
4 4
|
||||
2 1 11
|
||||
1 3 2 4
|
||||
1 3 2 4
|
||||
```
|
||||
|
||||
### 输出 #3
|
||||
|
||||
```
|
||||
0
|
||||
```
|
||||
+25
@@ -0,0 +1,25 @@
|
||||
#include <bits/stdc++.h>
|
||||
using namespace std;
|
||||
set<int> s;
|
||||
map<int, int> rev;
|
||||
int n;
|
||||
int tmp;
|
||||
int main(void) {
|
||||
scanf("%d%d", &n, &tmp), s.insert(tmp), rev[tmp] = 1;
|
||||
for(int i = 2; i <= n; i++) {
|
||||
scanf("%d", &tmp), s.insert(tmp), rev[tmp] = i;
|
||||
auto lb = s.lower_bound(tmp), ub = s.upper_bound(tmp);
|
||||
int minval = INT_MAX, ind = 0;
|
||||
if(lb != s.begin()) {
|
||||
--lb;
|
||||
if(abs(tmp - *lb) < minval)
|
||||
minval = abs(tmp - *lb), ind = rev[*lb];
|
||||
}
|
||||
if(ub != s.end())
|
||||
if(abs(tmp - *ub) < minval)
|
||||
minval = abs(tmp - *ub), ind = rev[*ub];
|
||||
printf("%d %d\n", minval, ind);
|
||||
}
|
||||
|
||||
return 0;
|
||||
}
|
||||
@@ -0,0 +1,47 @@
|
||||
# P10466 邻值查找
|
||||
|
||||
## 题目描述
|
||||
|
||||
给定一个长度为 $n$ 的序列 $A$,$A$ 中的数各不相同。
|
||||
|
||||
对于 $A$ 中的每一个数 $A_i$,求:
|
||||
|
||||
$\min_{1 \le j <i}|A_i-A_j|$
|
||||
|
||||
以及令上式取到最小值的 $j$(记为 $P_i$)。若最小值点不唯一,则选择使 $A_j$ 较小的那个。
|
||||
|
||||
## 输入格式
|
||||
|
||||
第一行输入整数 $n$,代表序列长度。
|
||||
|
||||
第二行输入 $n$ 个整数 $A_1 \sim A_n$,代表序列的具体数值,数值之间用空格隔开。
|
||||
|
||||
## 输出格式
|
||||
|
||||
输出共 $n-1$ 行,每行输出两个整数,数值之间用空格隔开。
|
||||
|
||||
分别表示当 $i$ 取 $2 \sim n$ 时,对应的 $\min_{1 \le j <i}|A_i-A_j|$ 和 $P_i$ 的值。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
3
|
||||
1 5 3
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
4 1
|
||||
2 1
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
对于 $30\%$ 的数据 $n \le 100$。
|
||||
|
||||
对于 $70\%$ 的数据 $n \le 10^4$。
|
||||
|
||||
对于 $100\%$ 的数据 $n \le 10^5,|A_i| \le 10^9$。
|
||||
+28
@@ -0,0 +1,28 @@
|
||||
#include<bits/stdc++.h>
|
||||
using namespace std;
|
||||
const int mod = 1145141923;
|
||||
int n, m;
|
||||
int a[1000005];
|
||||
unordered_map<int, bool> ma;
|
||||
int _0;
|
||||
int main() {
|
||||
scanf("%d%d", &n, &m);
|
||||
for(int i = 1; i <= n; ++i) {
|
||||
scanf("%d", &a[i]);
|
||||
if(a[i]) {
|
||||
if(!ma[a[i]]) ma[a[i]] = 1;
|
||||
else {
|
||||
printf("0\n");
|
||||
return 0;
|
||||
}
|
||||
} else {
|
||||
_0++;
|
||||
}
|
||||
}
|
||||
long long ans = 1;
|
||||
for(int i = m - n + _0; i > m - n; --i) {
|
||||
ans = (ans * i) % mod;
|
||||
}
|
||||
printf("%lld\n", ans);
|
||||
return 0;
|
||||
}
|
||||
@@ -0,0 +1,73 @@
|
||||
# P11681 [Algo Beat Contest 001 C] Creating a Queue
|
||||
|
||||
## 题目背景
|
||||
|
||||
| Problem | Score | Idea | Std | Data | Check | Solution |
|
||||
| :---------------------------------: | :---: | :---------------------------------------------------: | :----------------------------------------------------------: | :---------------------------------------------: | :----------------------------------------------------------: | :----------------------------------------------------------: |
|
||||
| $\text{C - Creating a Queue}$ | $400$ | [joe_zxq](https://www.luogu.com.cn/user/623577) | [fanchuanyu](https://www.luogu.com.cn/user/706256) & [joe_zxq](https://www.luogu.com.cn/user/623577) | [joe_zxq](https://www.luogu.com.cn/user/623577) | [remmymilkyway](https://www.luogu.com.cn/user/551981) | [Link](https://www.luogu.com.cn/article/7r5l2cag) by [joe_zxq](https://www.luogu.com.cn/user/623577) |
|
||||
|
||||
## 题目描述
|
||||
|
||||
给定一个长度为 $N$ 的非负整数序列 $A$。
|
||||
|
||||
现在你需要用 $1\sim M$ 之间的正整数替换所有序列 $A$ 中的 $0$,使得对于其中的任何一段长度大于等于 $2$ 的子数组,不能存在唯一众数。
|
||||
|
||||
> 子数组:在一个数组中,选择一些连续的元素组成的新数组。
|
||||
>
|
||||
> 唯一众数:众数指的是一个数字序列中出现次数最多的元素。如果一个数字序列众数只有一个,我们称这个序列有唯一众数。
|
||||
|
||||
求有多少种不同方案,答案对 $1145141923$ 取模。两种方案称为不同,当且仅当替换后的序列至少有一位上的数不同。
|
||||
|
||||
## 输入格式
|
||||
|
||||
第一行包含两个正整数 $N$ 和 $M$,表示序列的长度和替换数的最大限度。
|
||||
|
||||
第二行包含 $N$ 个非负整数,表示序列 $A$ 的元素。
|
||||
|
||||
## 输出格式
|
||||
|
||||
一行一个非负整数,表示方案的数量,答案对 $1145141923$ 取模。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
2 3
|
||||
1 0
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
2
|
||||
```
|
||||
|
||||
## 输入输出样例 #2
|
||||
|
||||
### 输入 #2
|
||||
|
||||
```
|
||||
4 1046
|
||||
114 514 191 981
|
||||
```
|
||||
|
||||
### 输出 #2
|
||||
|
||||
```
|
||||
1
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
#### 样例解释 #1
|
||||
|
||||
有 $2$ 个满足条件的序列,分别为 $\{1,2\}$ 和 $\{1,3\}$。
|
||||
|
||||
#### 样例解释 #2
|
||||
|
||||
序列已经完全固定,本身就是一种合法的序列,于是答案为 $1$。
|
||||
|
||||
#### 数据范围
|
||||
|
||||
对于 $100\%$ 的数据,保证 $1 \le N \le 10^6$,$1 \le M \le 10^9$,$0 \le A_i \le M$。
|
||||
+61
@@ -0,0 +1,61 @@
|
||||
#include<bits/stdc++.h>
|
||||
using namespace std;
|
||||
int n;
|
||||
vector<int> chi[100005];
|
||||
int fa[100005][25];
|
||||
int minc[100005][25];
|
||||
int q;
|
||||
int a;
|
||||
void pre(int now) {
|
||||
for(int i = 1; i <= 20; ++i) {
|
||||
fa[now][i] = fa[fa[now][i - 1]][i - 1];
|
||||
}
|
||||
for(int i : chi[now]) {
|
||||
pre(i);
|
||||
}
|
||||
for(int i = 1; i <= 20; ++i) {
|
||||
minc[now][i] = minc[minc[now][i - 1]][i - 1];
|
||||
}
|
||||
}
|
||||
int main() {
|
||||
scanf("%d%d", &n, &q);
|
||||
fa[1][0] = 1;
|
||||
for(int i = 2; i <= n; ++i) {
|
||||
scanf("%d", &fa[i][0]);
|
||||
chi[fa[i][0]].push_back(i);
|
||||
}
|
||||
for(int i = 1; i <= n; ++i) {
|
||||
minc[i][0] = INT_MAX;
|
||||
for(int j : chi[i]) {
|
||||
minc[i][0] = min(minc[i][0], j);
|
||||
}
|
||||
if(minc[i][0] == INT_MAX) minc[i][0] = i;
|
||||
}
|
||||
pre(1);
|
||||
while(q--) {
|
||||
int s, k;
|
||||
scanf("%d%d", &s, &k);
|
||||
for(int i = 1; i <= k; ++i) {
|
||||
scanf("%d", &a);
|
||||
if(a > 0) {
|
||||
for(int j = 20; j >= 0; --j) {
|
||||
if(a >= (1 << j)) {
|
||||
a -= (1 << j);
|
||||
s = fa[s][j];
|
||||
}
|
||||
}
|
||||
} else {
|
||||
a = -a;
|
||||
for(int j = 20; j >= 0; --j) {
|
||||
if(a >= (1 << j)) {
|
||||
a -= (1 << j);
|
||||
s = minc[s][j];
|
||||
}
|
||||
}
|
||||
}
|
||||
}
|
||||
// printf("111: %d\n", fa[5][0]);
|
||||
printf("%d\n", s);
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
@@ -0,0 +1,97 @@
|
||||
# P13019 [GESP202506 八级] 树上旅行
|
||||
|
||||
## 题目背景
|
||||
|
||||
对应的选择、判断题:<https://ti.luogu.com.cn/problemset/1188>
|
||||
|
||||
## 题目描述
|
||||
|
||||
给定一棵有 $ n $ 个结点的 **有根树**,结点依次以 $1,2,\dots,n$ 编号,其中根结点的编号为 $1$。
|
||||
|
||||
小 A 计划在这棵有根树上进行 $q$ 次旅行。在第 $i$ 次旅行中,小 A 首先选定结点 $s_i$ 作为起点,并移动若干次。移动分为以下两种:
|
||||
|
||||
1. 移动至当前结点的父结点。特殊地,如果当前位于根结点,则不进行移动。
|
||||
2. 移动至当前结点的所有子结点中**编号最小**的结点。特殊地,如果当前位于叶子结点,则不进行移动。
|
||||
|
||||
由于移动次数可能很大,对于第 $i$ 次旅行,旅行中的移动以 $k_i$ 个不为零的整数构成的序列 $a_{i,1}, a_{i,2}, \dots, a_{i,k_i}$ 表示。对 $a_{i,j}$,若 $a_{i,j} > 0$ 则代表进行 $a_{i,j}$ 次第一种移动;若 $a_{i,j} < 0$ 则代表进行 $-a_{i,j}$ 次第二种移动。根据给出的序列从左至右完成所有移动后,小 A 所在的结点即是旅行的**终点**。
|
||||
|
||||
给定每次旅行的起点与移动序列,请你求出旅行终点的结点编号。
|
||||
|
||||
## 输入格式
|
||||
|
||||
第一行,两个正整数 $n, q$,分别表示有根树的结点数量,以及旅行次数。
|
||||
|
||||
第二行,$n-1$ 个整数 $p_2, p_3, \dots, p_n$,其中 $p_i$ 表示结点 $i$ 的父结点编号。
|
||||
|
||||
接下来 $2q$ 行中的第 $2i-1$ 行($1 \leq i \leq q$)包含两个正整数 $s_i, k_i$,分别表示第 $i$ 次旅行的起点编号,以及移动序列的长度。第 $2i$ 行包含 $k_i$ 个整数 $a_{i,1}, a_{i,2}, \dots, a_{i,k_i}$,表示移动序列。
|
||||
|
||||
## 输出格式
|
||||
|
||||
输出共 $q$ 行,第 $i$ 行包含一个整数,表示第 $i$ 次旅行终点的结点编号。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
5 4
|
||||
1 1 2 2
|
||||
3 3
|
||||
1 -1 -1
|
||||
2 5
|
||||
1 -1 1 -1 1
|
||||
5 8
|
||||
1 1 1 -1 -1 -1 -1 -1
|
||||
5 3
|
||||
-1 -1 1
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
4
|
||||
1
|
||||
4
|
||||
2
|
||||
```
|
||||
|
||||
## 输入输出样例 #2
|
||||
|
||||
### 输入 #2
|
||||
|
||||
```
|
||||
8 3
|
||||
5 4 2 1 3 6 6
|
||||
8 1
|
||||
8
|
||||
8 2
|
||||
8 -8
|
||||
8 3
|
||||
8 -8 8
|
||||
```
|
||||
|
||||
### 输出 #2
|
||||
|
||||
```
|
||||
1
|
||||
7
|
||||
1
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
| 子任务编号 | 测试点占比 | $n$ | $q$ | $\sum k_i$ | 特殊性质 |
|
||||
|:-:|:-:|:-:|:-:|:-:|:-:|
|
||||
| $1$ | $20\%$ | $\leq 100$ | $\leq 100$ | $\leq 1000$ | 保证 $a_{i,j}$ 为 $1$ 或 $-1$ |
|
||||
| $2$ | $20\%$ | $\leq 10^4$ | $\leq 10^4$ | $\leq 4 \times 10^4$ | 仅包含第一种移动 |
|
||||
| $3$ | $20\%$ | $\leq 10^4$ | $\leq 10^4$ | $\leq 4 \times 10^4$ | 仅包含第二种移动 |
|
||||
| $4$ | $40\%$ | $\leq 10^5$ | $\leq 2 \times 10^4$ | $\leq 10^5$ | - |
|
||||
|
||||
对于所有测试点,保证:
|
||||
|
||||
- $1 \leq n \leq 10^5$
|
||||
- $1 \leq q \leq 2 \times 10^4$
|
||||
- $1 \leq p_i \leq n$
|
||||
- $1 \leq s_i \leq n$
|
||||
- $k_i \geq 1$ 且 $\sum k_i \leq 10^5$
|
||||
- $1 \leq |a_{i,j}| \leq n$
|
||||
@@ -0,0 +1,156 @@
|
||||
#include<bits/stdc++.h>
|
||||
using namespace std;
|
||||
int n;
|
||||
vector<pair<int, int>> fri[200005];
|
||||
pair<int, int> edge[200005];
|
||||
int a[200005];
|
||||
int fa[200005];
|
||||
int dfn[200005];
|
||||
int nowdfn;
|
||||
int cnt[200005];
|
||||
int son[200005];
|
||||
int top[200005];
|
||||
int dep[200005];
|
||||
int m;
|
||||
struct SEG{
|
||||
int num[3][800005];
|
||||
bool lt[800005];
|
||||
void pu(int now, int op) {
|
||||
if(op == 0) num[op][now] = num[op][now * 2] + num[op][now * 2 + 1];
|
||||
else if(op == 1) num[op][now] = max(num[op][now * 2], num[op][now * 2 + 1]);
|
||||
else num[op][now] = min(num[op][now * 2], num[op][now * 2 + 1]);
|
||||
}
|
||||
void pu(int now) {pu(now, 0), pu(now, 1), pu(now, 2);}
|
||||
void dorev(int now) {
|
||||
lt[now] ^= 1;
|
||||
num[0][now] = -num[0][now];
|
||||
int tmp = num[1][now];
|
||||
num[1][now] = -num[2][now];
|
||||
num[2][now] = -tmp;
|
||||
}
|
||||
void pd(int now, int nl, int nr) {
|
||||
if(!lt[now]) return;
|
||||
dorev(now * 2);
|
||||
dorev(now * 2 + 1);
|
||||
lt[now] = 0;
|
||||
}
|
||||
void edit(int now, int nl, int nr, int l, int nn) {
|
||||
if(l < nl || l > nr) return;
|
||||
if(nl == nr) {
|
||||
num[0][now] = nn, num[1][now] = nn, num[2][now] = nn;
|
||||
return;
|
||||
}
|
||||
int nmid = (nl + nr) >> 1;
|
||||
pd(now, nl, nr);
|
||||
edit(now * 2, nl, nmid, l, nn);
|
||||
edit(now * 2 + 1, nmid + 1, nr, l, nn);
|
||||
pu(now);
|
||||
}
|
||||
void rev(int now, int nl, int nr, int l, int r) {
|
||||
if(nr < l || nl > r) return;
|
||||
if(l <= nl && nr <= r) {
|
||||
dorev(now);
|
||||
return;
|
||||
}
|
||||
pd(now, nl, nr);
|
||||
int nmid = (nl + nr) >> 1;
|
||||
rev(now * 2, nl, nmid, l, r);
|
||||
rev(now * 2 + 1, nmid + 1, nr, l, r);
|
||||
pu(now);
|
||||
}
|
||||
int query(int now, int nl, int nr, int l, int r, int op) {
|
||||
if(nr < l || nl > r) return (op==2)?INT_MAX:((op==1)?INT_MIN:0);
|
||||
if(l <= nl && nr <= r) {
|
||||
return num[op][now];
|
||||
}
|
||||
int nmid = (nl + nr) >> 1;
|
||||
pd(now, nl, nr);
|
||||
if(op == 0) return query(now * 2, nl, nmid, l, r, op) + query(now * 2 + 1, nmid + 1, nr, l, r, op);
|
||||
else if(op == 1) return max(query(now * 2, nl, nmid, l, r, op), query(now * 2 + 1, nmid + 1, nr, l, r, op));
|
||||
else return min(query(now * 2, nl, nmid, l, r, op), query(now * 2 + 1, nmid + 1, nr, l, r, op));
|
||||
}
|
||||
}seg;
|
||||
void dfs1(int now, int from) {
|
||||
cnt[now] = 1;
|
||||
for(pair<int, int> i : fri[now]) {
|
||||
if(i.second == from) continue;
|
||||
a[i.second] = i.first; // 边权转点权
|
||||
fa[i.second] = now;
|
||||
dep[i.second] = dep[now] + 1;
|
||||
dfs1(i.second, now);
|
||||
cnt[now] += cnt[i.second];
|
||||
if(cnt[i.second] > cnt[son[now]]) son[now] = i.second;
|
||||
}
|
||||
}
|
||||
void dfs2(int now, int from) {
|
||||
dfn[now] = ++nowdfn;
|
||||
seg.edit(1, 1, n, nowdfn, a[now]);
|
||||
top[now] = from;
|
||||
if(son[now]) dfs2(son[now], from);
|
||||
for(pair<int, int> i : fri[now]) {
|
||||
if(i.second == son[now] || i.second == fa[now]) continue;
|
||||
dfs2(i.second, i.second);
|
||||
}
|
||||
}
|
||||
void rev(int u, int v) {
|
||||
while(top[u] != top[v]) {
|
||||
if(dep[top[u]] < dep[top[v]]) swap(u, v);
|
||||
seg.rev(1, 1, n, dfn[top[u]], dfn[u]);
|
||||
u = fa[top[u]];
|
||||
}
|
||||
if(dep[u] < dep[v]) swap(u, v);
|
||||
if(dfn[v] + 1 <= dfn[u])
|
||||
seg.rev(1, 1, n, dfn[v] + 1, dfn[u]);
|
||||
}
|
||||
int f(int u, int v, int op) {
|
||||
int ans = 0;
|
||||
if(op == 1) ans = INT_MIN;
|
||||
if(op == 2) ans = INT_MAX;
|
||||
while(top[u] != top[v]) {
|
||||
if(dep[top[u]] < dep[top[v]]) swap(u, v);
|
||||
if(op == 0) ans += seg.query(1, 1, n, dfn[top[u]], dfn[u], 0);
|
||||
else if(op == 1) ans = max(ans, seg.query(1, 1, n, dfn[top[u]], dfn[u], 1));
|
||||
else ans = min(ans, seg.query(1, 1, n, dfn[top[u]], dfn[u], 2));
|
||||
u = fa[top[u]];
|
||||
}
|
||||
if(dep[u] < dep[v]) swap(u, v);
|
||||
if(dfn[v] + 1 <= dfn[u]) {
|
||||
if(op == 0) ans += seg.query(1, 1, n, dfn[v] + 1, dfn[u], 0);
|
||||
else if(op == 1) ans = max(ans, seg.query(1, 1, n, dfn[v] + 1, dfn[u], 1));
|
||||
else ans = min(ans, seg.query(1, 1, n, dfn[v] + 1, dfn[u], 2));
|
||||
}
|
||||
return ans;
|
||||
}
|
||||
int main() {
|
||||
scanf("%d", &n);
|
||||
for(int i = 1, u, v, w; i < n; ++i) {
|
||||
scanf("%d%d%d", &u, &v, &w);
|
||||
u++, v++;
|
||||
fri[u].push_back({w, v});
|
||||
fri[v].push_back({w, u});
|
||||
edge[i] = {u, v};
|
||||
}
|
||||
dfs1(1, 0);
|
||||
dfs2(1, 1);
|
||||
scanf("%d", &m);
|
||||
while(m--) {
|
||||
char op[5];
|
||||
int u, v;
|
||||
scanf("%s%d%d", op, &u, &v);
|
||||
if(op[0] == 'C') {
|
||||
pair<int, int> ed = edge[u];
|
||||
if(dep[ed.first] > dep[ed.second]) u = ed.first;
|
||||
else u = ed.second;
|
||||
seg.edit(1, 1, n, dfn[u], v);
|
||||
} else if(op[0] == 'N') {
|
||||
rev(u + 1, v + 1);
|
||||
} else if(op[0] == 'S') {
|
||||
printf("%d\n", f(u + 1, v + 1, 0));
|
||||
} else if(op[1] == 'A') {
|
||||
printf("%d\n", f(u + 1, v + 1, 1));
|
||||
} else {
|
||||
printf("%d\n", f(u + 1, v + 1, 2));
|
||||
}
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
@@ -0,0 +1,72 @@
|
||||
# P1505 [国家集训队] 旅游
|
||||
|
||||
## 题目背景
|
||||
|
||||
Ray 乐忠于旅游,这次他来到了 T 城。T 城是一个水上城市,一共有 $n$ 个景点,有些景点之间会用一座桥连接。为了方便游客到达每个景点但又为了节约成本,T 城的任意两个景点之间有且只有一条路径。换句话说, T 城中只有 $n-1$ 座桥。
|
||||
|
||||
Ray 发现,有些桥上可以看到美丽的景色,让人心情愉悦,但有些桥狭窄泥泞,令人烦躁。于是,他给每座桥定义一个愉悦度 $w$,也就是说,Ray 经过这座桥会增加 $w$ 的愉悦度,这或许是正的也可能是负的。有时,Ray 看待同一座桥的心情也会发生改变。
|
||||
|
||||
现在,Ray 想让你帮他计算从 $u$ 景点到 $v$ 景点能获得的总愉悦度。有时,他还想知道某段路上最美丽的桥所提供的最大愉悦度,或是某段路上最糟糕的一座桥提供的最低愉悦度。
|
||||
|
||||
## 题目描述
|
||||
|
||||
给定一棵 $n$ 个节点的树,边带权,点的编号为 $0 \sim n-1$,需要支持五种操作:
|
||||
|
||||
- `C i w` 将输入的第 $i$ 条边权值改为 $w$;
|
||||
- `N u v` 将 $u,v$ 节点之间的边权都变为相反数;
|
||||
- `SUM u v` 询问 $u,v$ 节点之间边权和;
|
||||
- `MAX u v` 询问 $u,v$ 节点之间边权最大值;
|
||||
- `MIN u v` 询问 $u,v$ 节点之间边权最小值。
|
||||
|
||||
保证任意时刻所有边的权值都在 $[-1000,1000]$ 内。
|
||||
|
||||
## 输入格式
|
||||
|
||||
第一行一个正整数 $n$,表示节点个数。
|
||||
接下来 $n-1$ 行,每行三个整数 $u,v,w$,表示 $u,v$ 之间有一条权值为 $w$ 的边,描述这棵树。
|
||||
然后一行一个正整数 $m$,表示操作数。
|
||||
接下来 $m$ 行,每行表示一个操作。
|
||||
|
||||
## 输出格式
|
||||
|
||||
对于每一个询问操作,输出一行一个整数表示答案。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
3
|
||||
0 1 1
|
||||
1 2 2
|
||||
8
|
||||
SUM 0 2
|
||||
MAX 0 2
|
||||
N 0 1
|
||||
SUM 0 2
|
||||
MIN 0 2
|
||||
C 1 3
|
||||
SUM 0 2
|
||||
MAX 0 2
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
3
|
||||
2
|
||||
1
|
||||
-1
|
||||
5
|
||||
3
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
【数据范围】
|
||||
|
||||
对于 $100\%$ 的数据,$1\le n,m \le 2\times 10^5$。
|
||||
|
||||
2020.02.04 修正了一点数据的错误
|
||||
2020.03.14 加入了一组 hack 数据
|
||||
2020.11.26 加入了一组 hack 数据 By @_Leaving
|
||||
+48
@@ -0,0 +1,48 @@
|
||||
#include<bits/stdc++.h>
|
||||
using namespace std;
|
||||
int n, p, q;
|
||||
int a[2005];
|
||||
int f[2005][2005];
|
||||
bool check(int w) {
|
||||
for(int i = 0; i <= p; ++i) {
|
||||
for(int j = 1; j <= n; ++j) {
|
||||
f[i][j] = 0x7f7f7f7f;
|
||||
}
|
||||
}
|
||||
for(int i = 1; i <= n; ++i) {
|
||||
int s = upper_bound(a + 1, a + n + 1, a[i] - w) - a - 1;
|
||||
int t = upper_bound(a + 1, a + n + 1, a[i] - 2 * w) - a - 1;
|
||||
f[0][i] = f[0][t] + 1;
|
||||
for(int j = 1; j <= p; ++j) {
|
||||
f[j][i] = min(f[j - 1][s], f[j][t] + 1);
|
||||
}
|
||||
}
|
||||
return f[p][n] <= q;
|
||||
}
|
||||
int main() {
|
||||
scanf("%d%d%d", &n, &p, &q);
|
||||
for (int i = 1; i <= n; ++i)
|
||||
{
|
||||
scanf("%d", &a[i]);
|
||||
}
|
||||
if (p + q >= n)
|
||||
{ // 若总数足够多,一个盯一个即可,固以下计算 p + q < 2000
|
||||
printf("1\n");
|
||||
return 0;
|
||||
}
|
||||
sort(a + 1, a + n + 1);
|
||||
int l = 1, r = 1e9;
|
||||
while(l < r) {
|
||||
int mid = l + (r - l) / 2;
|
||||
if(check(mid)) r = mid;
|
||||
else l = mid + 1;
|
||||
}
|
||||
printf("%d\n", l);
|
||||
return 0;
|
||||
}
|
||||
/*
|
||||
f i, k为仅用 i 个小区间处理完前 k 个点所用最少的大区间个数。
|
||||
|
||||
|
||||
f{i, k} = min(f{i − 1, s}, f{i, t} + 1)
|
||||
*/
|
||||
@@ -0,0 +1,95 @@
|
||||
# P15823 [JOI Open 2013] 观影 / Watching
|
||||
|
||||
## 题目描述
|
||||
|
||||
澳大利亚有许多有趣的文化,例如各种体育运动和种类繁多的动物。你正试图观看在布里斯班的一条道路上举办的许多活动。
|
||||
|
||||
这条道路被划分为 $1\,000\,000\,000$ 个区段。这些区段从西到东编号为 $1, 2, \dots, 1\,000\,000\,000$。你想观看 $N$ 场活动。第 $i$ 场活动将在区段 $A_i$ 上举办。
|
||||
|
||||
为了观看这些活动,你准备了 $P$ 台小型摄像机和 $Q$ 台大型摄像机。你可以选择一个正整数 $w$ 作为拍摄参数。然后,一台小型摄像机可以拍摄**最多**连续 $w$ 个区段,一台大型摄像机可以拍摄**最多**连续 $2w$ 个区段。同一个区段可以被多台摄像机拍摄。你想拍摄所有举办活动的区段。由于预计会有很多人前往活动现场,出于安全考虑,你必须固定摄像机的位置,并且在活动期间不允许移动它们。参数 $w$ 越大,拍摄的成本就越高。因此,你希望最小化 $w$ 的值。
|
||||
|
||||
### 任务
|
||||
|
||||
编写一个程序,根据给定的活动信息和摄像机数量,确定能够拍摄所有活动所在区段所需的最小 $w$ 值。
|
||||
|
||||
## 输入格式
|
||||
|
||||
从标准输入读取以下数据。
|
||||
|
||||
- 输入的第一行包含三个以空格分隔的整数 $N, P, Q$。其中 $N$ 是活动的数量,$P$ 是小型摄像机的数量,$Q$ 是大型摄像机的数量。
|
||||
- 接下来的 $N$ 行中,第 $i$ 行($1 \le i \le N$)包含一个整数 $A_i$,表示第 $i$ 场活动举办的区段编号。
|
||||
|
||||
## 输出格式
|
||||
|
||||
向标准输出写入一个整数,表示能够拍摄所有活动所在区段所需的最小 $w$ 值。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
3 1 1
|
||||
2
|
||||
11
|
||||
17
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
4
|
||||
```
|
||||
|
||||
## 输入输出样例 #2
|
||||
|
||||
### 输入 #2
|
||||
|
||||
```
|
||||
13 3 2
|
||||
33
|
||||
66
|
||||
99
|
||||
10
|
||||
83
|
||||
68
|
||||
19
|
||||
83
|
||||
93
|
||||
53
|
||||
15
|
||||
66
|
||||
75
|
||||
```
|
||||
|
||||
### 输出 #2
|
||||
|
||||
```
|
||||
9
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
### 样例解释
|
||||
|
||||
在第一个样例中,当你选择 $w = 4$ 时,就可以拍摄所有活动所在的区段。例如,你可以用一台小型摄像机拍摄从区段 1 到 3 的区域,用一台大型摄像机拍摄从区段 11 到 18 的区域。
|
||||
|
||||
### 约束条件
|
||||
|
||||
所有输入数据满足以下条件。
|
||||
|
||||
- $1 \le N \le 2000$。
|
||||
- $1 \le P \le 100\,000$。
|
||||
- $1 \le Q \le 100\,000$。
|
||||
- $1 \le A_i \le 1\,000\,000\,000$($1 \le i \le N$)。
|
||||
|
||||
### 子任务
|
||||
|
||||
#### 子任务 1 [50 分]
|
||||
|
||||
- 满足 $N \le 100$。
|
||||
|
||||
#### 子任务 2 [50 分]
|
||||
|
||||
- 无额外约束。
|
||||
|
||||
翻译由 DeepSeek V3.2 完成
|
||||
+24
@@ -0,0 +1,24 @@
|
||||
#include <bits/stdc++.h>
|
||||
using namespace std;
|
||||
int side(char c) {
|
||||
if (c == 'A' || c == 'B' || c == 'C') return 0;
|
||||
return 1;
|
||||
}
|
||||
int pos(char c) {
|
||||
if (c == 'A') return 0;
|
||||
if (c == 'B') return 1;
|
||||
if (c == 'C') return 2;
|
||||
if (c == 'D') return 0;
|
||||
return 1; // 'F'
|
||||
}
|
||||
int main() {
|
||||
string c1, s1, c2, s2;
|
||||
cin >> c1 >> s1 >> c2 >> s2;
|
||||
bool ans1 = (c1 == c2);
|
||||
bool ans2 = ans1 && (s1.substr(0, 2) == s2.substr(0, 2));
|
||||
char a = s1[2], b = s2[2];
|
||||
bool ans3 = ans2 && (side(a) == side(b));
|
||||
bool ans4 = ans3 && (abs(pos(a) - pos(b)) == 1);
|
||||
cout << ans1 << ans2 << ans3 << ans4 << '\n';
|
||||
return 0;
|
||||
}
|
||||
@@ -0,0 +1,137 @@
|
||||
# P17827 [CSP-J 2026] 旅游 / travel(民间数据)
|
||||
|
||||
## 题目描述
|
||||
|
||||
小 R 和小 X 准备坐高铁出门旅游。他们买了两张二等座车票,车票上写着各自的车厢号和座位号。两人希望座位相邻,这样旅途中可以坐在一起。
|
||||
|
||||
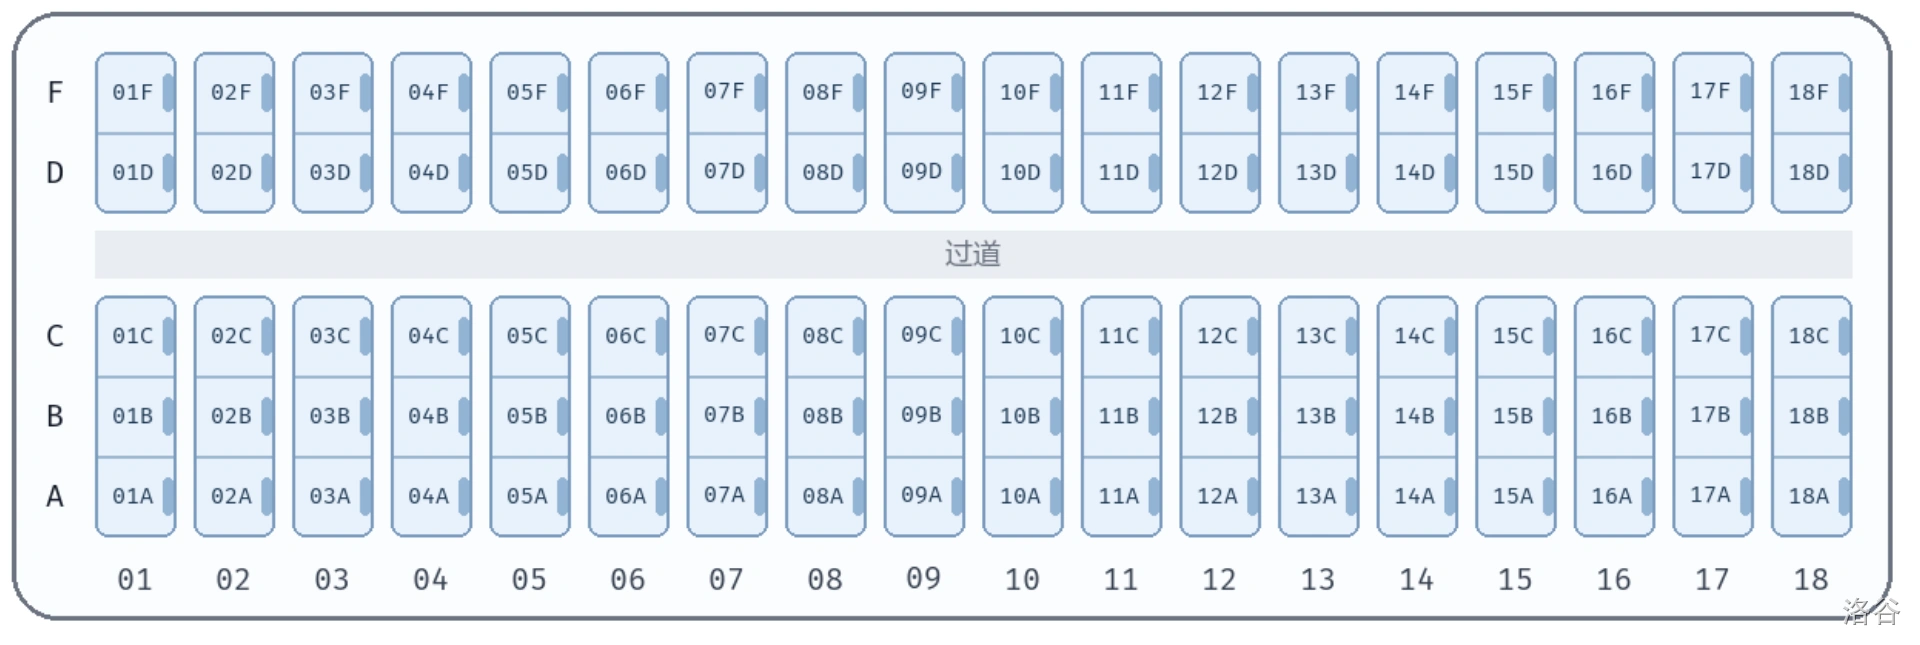
他们乘坐的列车由 $17$ 节车厢组成,车厢编号是 `01` 到 `17`。其中,`01` 和 `16` 号车厢是一等座车厢,其余车厢是二等座车厢。两人买的都是二等座车票,座位都在二等座车厢中。每节二等座车厢共有 $18$ 排,每排有 $5$ 个座位。座位号由两位排号和一位大写字母组成,例如 `03C` 表示第 $3$ 排 C 座。每一排的座位按照从左到右的顺序排列,座位字母依次是 `A`、`B`、`C`、`D`、`F`,其中 C 座与 D 座之间是过道,即每排过道左侧的座位序列是 `A`、`B`、`C`,右侧是 `D`、`F`。以下是一节二等座车厢的座位示意图:
|
||||
|
||||
:::align{center}
|
||||
|
||||
:::
|
||||
|
||||
两个座位相邻,当且仅当在同一节车厢的同一排,位于过道的同一侧,且在该侧的座位序列中相邻。
|
||||
|
||||
你需要帮助小 R 依次判断:
|
||||
|
||||
- 两张车票对应的座位是否在同一节车厢;
|
||||
- 两张车票对应的座位是否在同一节车厢的同一排;
|
||||
- 两张车票对应的座位是否在同一节车厢的同一排,且位于过道的同一侧;
|
||||
- 两张车票对应的座位是否相邻。
|
||||
|
||||
## 输入格式
|
||||
|
||||
从文件 `travel.in` 中读入数据。
|
||||
|
||||
输入的第一行包含四个字符串 $c_1,s_1,c_2,s_2$,分别表示小 R 的车票上的车厢号、座位号,以及小 X 的车票上的车厢号、座位号。
|
||||
|
||||
## 输出格式
|
||||
|
||||
输出到文件 `travel.out` 中。
|
||||
|
||||
输出一行一个长度为 $4$ 的 `01` 字符串,分别表示四个问题的答案,其中 `1` 代表是,`0` 代表否。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
02 01A 02 01B
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
1111
|
||||
```
|
||||
|
||||
## 输入输出样例 #2
|
||||
|
||||
### 输入 #2
|
||||
|
||||
```
|
||||
02 01C 02 01A
|
||||
```
|
||||
|
||||
### 输出 #2
|
||||
|
||||
```
|
||||
1110
|
||||
```
|
||||
|
||||
## 输入输出样例 #3
|
||||
|
||||
### 输入 #3
|
||||
|
||||
```
|
||||
02 01C 02 01D
|
||||
```
|
||||
|
||||
### 输出 #3
|
||||
|
||||
```
|
||||
1100
|
||||
```
|
||||
|
||||
## 输入输出样例 #4
|
||||
|
||||
### 输入 #4
|
||||
|
||||
```
|
||||
02 02B 02 01A
|
||||
```
|
||||
|
||||
### 输出 #4
|
||||
|
||||
```
|
||||
1000
|
||||
```
|
||||
|
||||
## 输入输出样例 #5
|
||||
|
||||
### 输入 #5
|
||||
|
||||
```
|
||||
02 01A 03 01A
|
||||
```
|
||||
|
||||
### 输出 #5
|
||||
|
||||
```
|
||||
0000
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
### 样例 1 解释
|
||||
|
||||
`02` 号车厢是二等座车厢。`01A` 和 `01B` 在同一节车厢、同一排、过道的同一侧,并且相邻,因此输出 `1111`。
|
||||
|
||||
### 样例 2 解释
|
||||
|
||||
两个座位在同一节车厢、同一排、过道的同一侧,但 `01C` 与 `01A` 中间隔着 `01B`,不相邻,因此输出 `1110`。
|
||||
|
||||
### 数据范围
|
||||
|
||||
对于所有测试数据,均有:
|
||||
|
||||
- $c_1,c_2$ 是 `01` 到 `17` 之间除 `01` 和 `16` 外的两位车厢号;
|
||||
- $s_1,s_2$ 是对应车厢中的合法座位号,即前两位是 `01` 到 `18` 之间的排号,末位是 `A`、`B`、`C`、`D`、`F` 中的一个字母;
|
||||
- 两张车票对应的不是同一个座位,即 $c_1\ne c_2$ 或 $s_1\ne s_2$。
|
||||
|
||||
::cute-table{tuack}
|
||||
| 测试点编号 | 特殊性质 |
|
||||
| :-: | :-: |
|
||||
| $1\sim 4$ | A, B, C |
|
||||
| $5\sim 10$ | A, B |
|
||||
| $11\sim 14$ | A |
|
||||
| $15\sim 17$ | D |
|
||||
| $18\sim 20$ | 无 |
|
||||
|
||||
特殊性质 A:两个座位在同一节车厢,即 $c_1=c_2$。
|
||||
|
||||
特殊性质 B:两个座位在同一排,即 $s_1$ 的前两位与 $s_2$ 的前两位相同。
|
||||
|
||||
特殊性质 C:两个座位在过道的同一侧。
|
||||
|
||||
特殊性质 D:小 R 的座位是 D 座,小 X 的座位是 F 座,即 $s_1$ 的末位字符是 `D`,$s_2$ 的末位字符是 `F`。
|
||||
+44
@@ -0,0 +1,44 @@
|
||||
#include<bits/stdc++.h>
|
||||
using namespace std;
|
||||
int n;
|
||||
long long m;
|
||||
long long a[500005];
|
||||
long long qsum[500005];
|
||||
bool checkb(int mid, long long now, int tot) {
|
||||
return mid * now - (qsum[tot] - qsum[tot - mid]) <= m;
|
||||
}
|
||||
long long check(long long now, int tot) {
|
||||
long long nowm = m;
|
||||
long long ans = 0;
|
||||
int l = 1, r = tot, mid = (l + r) >> 1;
|
||||
while(l < r) {
|
||||
mid = (l + r) >> 1;
|
||||
if(checkb(mid, now, tot)) {
|
||||
l = mid + 1;
|
||||
} else {
|
||||
r = mid;
|
||||
}
|
||||
}
|
||||
while(!checkb(mid, now, tot) && mid >= 1) mid--;
|
||||
while(checkb(mid + 1, now, tot) && mid + 1 <= tot) mid++;
|
||||
return mid;
|
||||
}
|
||||
int main() {
|
||||
scanf("%d%lld", &n, &m);
|
||||
for(int i = 1; i <= n; ++i) scanf("%lld", &a[i]);
|
||||
sort(a + 1, a + n + 1);
|
||||
for(int i = 1; i <= n; ++i) qsum[i] = qsum[i - 1] + a[i];
|
||||
long long ans = 0;
|
||||
for(int i = 1; i <= n; ++i) {
|
||||
if(a[i + 1] == a[i]) continue;
|
||||
ans = max(ans, check(a[i], i));
|
||||
// printf("%d %lld\n", i, check(a[i], i));
|
||||
}
|
||||
printf("%lld\n", ans);
|
||||
return 0;
|
||||
}
|
||||
/*
|
||||
g++ crystal/crystal.cpp -o crystal/crystal -std=c++14 -O2 -static -Wall && cp crystal/crystal ~ && chmod +x ~/crystal && ~/crystal
|
||||
O(n log n)
|
||||
100pts
|
||||
*/
|
||||
@@ -0,0 +1,95 @@
|
||||
# P17831 [CSP-S 2026] 能量水晶 / crystal(民间数据)
|
||||
|
||||
## 题目描述
|
||||
|
||||
小 R 有 $n$ 颗能量水晶,其中第 $i$ $(1 \le i \le n)$ 颗的能量值为整数 $a_i$。
|
||||
|
||||
小 R 想用其中若干颗能量水晶合成一颗大水晶,用于合成的水晶必须具有相同的能量值。小 R 希望参与合成的水晶尽可能多。他可以进行**至多** $m$ 次操作。每次操作可以任选一颗水晶,将其能量值增加 $1$;同一颗水晶可以被重复选择。
|
||||
|
||||
你需要帮助小 R 求出,进行至多 $m$ 次操作后,他最多能用多少颗能量水晶合成一颗大水晶。
|
||||
|
||||
## 输入格式
|
||||
|
||||
从文件 `crystal.in` 中读入数据。
|
||||
|
||||
输入的第一行包含一个正整数 $n$ 和一个非负整数 $m$,分别表示能量水晶的数量和最多可以进行的操作次数。
|
||||
|
||||
输入的第二行包含 $n$ 个整数 $a_1,a_2,\ldots,a_n$,依次表示每颗能量水晶的能量值。
|
||||
|
||||
## 输出格式
|
||||
|
||||
输出到文件 `crystal.out` 中。
|
||||
|
||||
输出一行一个正整数,表示进行至多 $m$ 次操作后,小 R 最多能用多少颗能量水晶合成一颗大水晶。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
5 5
|
||||
1 2 4 8 9
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
3
|
||||
```
|
||||
|
||||
## 输入输出样例 #2
|
||||
|
||||
### 输入 #2
|
||||
|
||||
```
|
||||
5 8
|
||||
-3 -1 2 2 7
|
||||
```
|
||||
|
||||
### 输出 #2
|
||||
|
||||
```
|
||||
4
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
### 样例 1 解释
|
||||
|
||||
小 R 有 $5$ 颗能量水晶,能量值分别为 $1,2,4,8,9$。他可以对能量值为 $1$ 和 $2$ 的水晶分别操作 $3$ 次和 $2$ 次,使原来能量值为 $1,2,4$ 的三颗水晶的能量值都变成 $4$,共进行 $5$ 次操作。因此小 R 可以用 $3$ 颗能量水晶合成一颗大水晶。
|
||||
|
||||
### 样例 3
|
||||
|
||||
见题目目录下的 `crystal/3.in` 与 `crystal/3.ans`。
|
||||
|
||||
该样例满足测试点 $8,9$ 的约束条件。
|
||||
|
||||
### 样例 4
|
||||
|
||||
见题目目录下的 `crystal/4.in` 与 `crystal/4.ans`。
|
||||
|
||||
该样例满足测试点 $10 \sim 12$ 的约束条件。
|
||||
|
||||
### 数据范围
|
||||
|
||||
对于所有测试数据,均有:
|
||||
|
||||
- $1 \le n \le 5 \times 10^5$,$0 \le m \le 10^{18}$;
|
||||
- 对于所有 $i$ $(1 \le i \le n)$,均有 $|a_i| \le 10^{12}$。
|
||||
|
||||
::cute-table{tuack}
|
||||
|
||||
| 测试点编号 | $n \le$ | $m \le$ | $\max_{i=1}^{n} \lvert a_i \rvert \le$ | 特殊性质 |
|
||||
| :-: | :-: | :-: | :-: | :-: |
|
||||
| $1,2$ | $5$ | $10$ | $20$ | 无 |
|
||||
| $3 \sim 5$ | $16$ | $1000$ | $20$ | 无 |
|
||||
| $6,7$ | $5000$ | $10^6$ | $100$ | 无 |
|
||||
| $8,9$ | $5000$ | $10^9$ | $10^5$ | 无 |
|
||||
| $10 \sim 12$ | $5 \times 10^5$ | $10^8$ | $100$ | 无 |
|
||||
| $13 \sim 15$ | $5 \times 10^5$ | $10^{18}$ | $10^{12}$ | A |
|
||||
| $16 \sim 18$ | $5 \times 10^5$ | $10^{18}$ | $10^{12}$ | B |
|
||||
| $19,20$ | $5 \times 10^5$ | $10^{18}$ | $10^{12}$ | 无 |
|
||||
|
||||
特殊性质 A:对于所有 $i$ $(1 \le i \le n)$,均有 $a_i=i$。
|
||||
|
||||
特殊性质 B:$a_1,a_2,\ldots,a_n$ 构成等差数列。
|
||||
@@ -0,0 +1,128 @@
|
||||
#include <bits/stdc++.h>
|
||||
using namespace std;
|
||||
int n, m, q;
|
||||
int a[10005];
|
||||
vector<pair<int, pair<int, int>>> edge;
|
||||
vector<pair<int, int>> fri[10005];
|
||||
struct BCJ {
|
||||
int fa[10005];
|
||||
int find(int x) {
|
||||
if (fa[x] == x) return x;
|
||||
return fa[x] = find(fa[x]);
|
||||
}
|
||||
} b;
|
||||
struct SEG {
|
||||
int num[10005 * 4];
|
||||
void init(int now, int nl, int nr) {
|
||||
if (nl == nr) {
|
||||
num[now] = a[nl];
|
||||
return;
|
||||
}
|
||||
int mid = (nl + nr) >> 1;
|
||||
init(now * 2, nl, mid);
|
||||
init(now * 2 + 1, mid + 1, nr);
|
||||
num[now] = min(num[now * 2], num[now * 2 + 1]);
|
||||
}
|
||||
int query(int now, int nl, int nr, int l, int r) {
|
||||
if (nr < l || nl > r) return INT_MAX;
|
||||
if (l <= nl && nr <= r) return num[now];
|
||||
int mid = (nl + nr) >> 1;
|
||||
return min(query(now * 2, nl, mid, l, r), query(now * 2 + 1, mid + 1, nr, l, r));
|
||||
}
|
||||
} seg;
|
||||
int fa[10005];
|
||||
pair<int, int> son[10005];
|
||||
int cnt[10005];
|
||||
int top[10005];
|
||||
int dfn[10005];
|
||||
int dep[10005];
|
||||
int nowdfn;
|
||||
void dfs1(int now, int from) {
|
||||
cnt[now] = 1;
|
||||
for (auto i : fri[now]) {
|
||||
int v = i.second;
|
||||
int w = i.first;
|
||||
if (v == from) continue;
|
||||
fa[v] = now;
|
||||
dep[v] = dep[now] + 1;
|
||||
dfs1(v, now);
|
||||
cnt[now] += cnt[v];
|
||||
if (cnt[son[now].first] < cnt[v]) {
|
||||
son[now].first = v;
|
||||
son[now].second = w;
|
||||
}
|
||||
}
|
||||
}
|
||||
void dfs2(int now, int from, int w) {
|
||||
dfn[now] = ++nowdfn;
|
||||
top[now] = from;
|
||||
a[dfn[now]] = w;
|
||||
if (son[now].first) {
|
||||
dfs2(son[now].first, from, son[now].second);
|
||||
}
|
||||
for (auto i : fri[now]) {
|
||||
int v = i.second;
|
||||
int ww = i.first;
|
||||
if (v == fa[now] || v == son[now].first) continue;
|
||||
dfs2(v, v, ww);
|
||||
}
|
||||
}
|
||||
int pt(int x, int y) {
|
||||
if (x == y) return INT_MAX;
|
||||
int ans = INT_MAX;
|
||||
while (top[x] != top[y]) {
|
||||
if (dep[top[x]] < dep[top[y]]) swap(x, y);
|
||||
ans = min(ans, seg.query(1, 1, n, dfn[top[x]], dfn[x]));
|
||||
x = fa[top[x]];
|
||||
}
|
||||
if (dep[x] < dep[y]) swap(x, y);
|
||||
if (dfn[y] + 1 <= dfn[x]) {
|
||||
ans = min(ans, seg.query(1, 1, n, dfn[y] + 1, dfn[x]));
|
||||
}
|
||||
return ans;
|
||||
}
|
||||
int main() {
|
||||
scanf("%d%d", &n, &m);
|
||||
for (int i = 1; i <= n; ++i) {
|
||||
b.fa[i] = i;
|
||||
}
|
||||
for (int i = 1, u, v, w; i <= m; ++i) {
|
||||
scanf("%d%d%d", &u, &v, &w);
|
||||
edge.push_back({w, {u, v}});
|
||||
}
|
||||
sort(edge.begin(), edge.end(),
|
||||
[](const pair<int, pair<int, int>> &x,
|
||||
const pair<int, pair<int, int>> &y) {
|
||||
return x.first > y.first;
|
||||
});
|
||||
for (auto i : edge) {
|
||||
int w = i.first;
|
||||
int u = i.second.first;
|
||||
int v = i.second.second;
|
||||
if (b.find(u) != b.find(v)) {
|
||||
fri[u].push_back({w, v});
|
||||
fri[v].push_back({w, u});
|
||||
b.fa[b.find(u)] = b.find(v);
|
||||
}
|
||||
}
|
||||
for (int i = 1; i <= n; ++i) {
|
||||
if (!dfn[i]) {
|
||||
dfs1(i, 0);
|
||||
dfs2(i, i, INT_MAX);
|
||||
}
|
||||
}
|
||||
seg.init(1, 1, n);
|
||||
scanf("%d", &q);
|
||||
while (q--) {
|
||||
int x, y;
|
||||
scanf("%d%d", &x, &y);
|
||||
if (b.find(x) != b.find(y)) {
|
||||
printf("-1\n");
|
||||
continue;
|
||||
}
|
||||
int ans = pt(x, y);
|
||||
printf("%d\n", ans == INT_MAX ? -1 : ans);
|
||||
}
|
||||
|
||||
return 0;
|
||||
}
|
||||
@@ -0,0 +1,58 @@
|
||||
# P1967 [NOIP 2013 提高组] 货车运输
|
||||
|
||||
## 题目背景
|
||||
|
||||
NOIP2013 提高组 D1T3
|
||||
|
||||
## 题目描述
|
||||
|
||||
A 国有 $n$ 座城市,编号从 $1$ 到 $n$,城市之间有 $m$ 条双向道路。每一条道路对车辆都有重量限制,简称限重。
|
||||
|
||||
现在有 $q$ 辆货车在运输货物,司机们想知道每辆车在不超过车辆限重的情况下,最多能运多重的货物。
|
||||
|
||||
## 输入格式
|
||||
|
||||
第一行有两个用一个空格隔开的整数 $n,m$,表示 A 国有 $n$ 座城市和 $m$ 条道路。
|
||||
|
||||
接下来 $m$ 行每行三个整数 $x, y, z$,每两个整数之间用一个空格隔开,表示从 $x$ 号城市到 $y$ 号城市有一条限重为 $z$ 的道路。
|
||||
注意:$x \neq y$,两座城市之间可能有多条道路。
|
||||
|
||||
接下来一行有一个整数 $q$,表示有 $q$ 辆货车需要运货。
|
||||
|
||||
接下来 $q$ 行,每行两个整数 $x,y$,之间用一个空格隔开,表示一辆货车需要从 $x$ 城市运输货物到 $y$ 城市,保证 $x \neq y$。
|
||||
|
||||
## 输出格式
|
||||
|
||||
共有 $q$ 行,每行一个整数,表示对于每一辆货车,它的最大载重是多少。
|
||||
如果货车不能到达目的地,输出 $-1$。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
4 3
|
||||
1 2 4
|
||||
2 3 3
|
||||
3 1 1
|
||||
3
|
||||
1 3
|
||||
1 4
|
||||
1 3
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
3
|
||||
-1
|
||||
3
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
对于 $30\%$ 的数据,$1 \le n < 1000$,$1 \le m < 10,000$,$1\le q< 1000$;
|
||||
|
||||
对于 $60\%$ 的数据,$1 \le n < 1000$,$1 \le m < 5\times 10^4$,$1 \le q< 1000$;
|
||||
|
||||
对于 $100\%$ 的数据,$1 \le n < 10^4$,$1 \le m < 5\times 10^4$,$1 \le q< 3\times 10^4 $,$0 \le z \le 10^5$。
|
||||
@@ -0,0 +1,64 @@
|
||||
#include<bits/stdc++.h>
|
||||
#define int long long
|
||||
using namespace std;
|
||||
int n;
|
||||
vector<int> fri[100005];
|
||||
int p[100005];
|
||||
int dfn[100005];
|
||||
int cnt[100005];
|
||||
int nowdfn;
|
||||
struct SEG{
|
||||
int num[400005], lt[400005];
|
||||
void pd(int now, int nl, int nr) {
|
||||
int nmid = (nl + nr) >> 1;
|
||||
num[now * 2] += lt[now] * (nmid - nl + 1);
|
||||
num[now * 2 + 1] += lt[now] * (nr - nmid);
|
||||
lt[now * 2] += lt[now];
|
||||
lt[now * 2 + 1] += lt[now];
|
||||
lt[now] = 0;
|
||||
}
|
||||
void pu(int now) {num[now] = num[now * 2] + num[now * 2 + 1];}
|
||||
void add(int now, int nl, int nr, int l, int r, int nn) {
|
||||
if(nl > r || nr < l) return;
|
||||
if(l <= nl && nr <= r) {
|
||||
num[now] += nn * (nr - nl + 1);
|
||||
lt[now] += nn;
|
||||
return;
|
||||
}
|
||||
int nmid = (nl + nr) >> 1;
|
||||
add(now * 2, nl, nmid, l, r, nn);
|
||||
add(now * 2 + 1, nmid + 1, nr, l, r, nn);
|
||||
pu(now);
|
||||
}
|
||||
int query(int now, int nl, int nr, int l, int r) {
|
||||
if(nl > r || nr < l) return 0;
|
||||
if(l <= nl && nr <= r) return num[now];
|
||||
int nmid = (nl + nr) >> 1;
|
||||
pd(now, nl, nr);
|
||||
return query(now * 2, nl, nmid, l, r) + query(now * 2 + 1, nmid + 1, nr, l, r);
|
||||
}
|
||||
}seg;
|
||||
void dfs(int now, int from) {
|
||||
cnt[now] = 1;
|
||||
dfn[now] = ++nowdfn;
|
||||
for(int i : fri[now]) {
|
||||
if(i == from) continue;
|
||||
dfs(i, now);
|
||||
cnt[now] += cnt[i];
|
||||
}
|
||||
}
|
||||
signed main() {
|
||||
scanf("%lld", &n);
|
||||
for(int i = 1, u, v; i < n; ++i) {
|
||||
scanf("%lld%lld", &u, &v);
|
||||
fri[u].push_back(v);
|
||||
fri[v].push_back(u);
|
||||
}
|
||||
dfs(1, 0);
|
||||
for(int i = 1; i <= n; ++i) {
|
||||
scanf("%lld", &p[i]);
|
||||
printf("%lld\n", seg.query(1, 1, n, dfn[p[i]], dfn[p[i]]));
|
||||
seg.add(1, 1, n, dfn[p[i]], dfn[p[i]] + cnt[p[i]] - 1, 1);
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
@@ -0,0 +1,105 @@
|
||||
# P2982 [USACO10FEB] Slowing down G
|
||||
|
||||
## 题目描述
|
||||
|
||||
每天,Farmer John 的 $N$ $(1 \le N \le 100{,}000)$ 头奶牛(方便地编号为 $1..N$)都会从牛棚走向各自的私人牧场。牧场形成一棵树,其中牛棚位于牧场 $1$。恰好有 $N-1$ 条无向路径连接这些牧场;直接相连的牧场之间恰好有一条路径。路径 $i$ 连接牧场 $A_i$ 和 $B_i$ $(1 \le A_i \le N, 1 \le B_i \le N)$。
|
||||
|
||||
奶牛 $i$ 拥有一个私人牧场 $P_i$ $(1 \le P_i \le N)$。牛棚的小门一次只能让一头奶牛出去,耐心的奶牛们会等待前一头奶牛到达她的私人牧场。首先,奶牛 $1$ 离开并走向牧场 $P_1$。接着奶牛 $2$ 离开并前往牧场 $P_2$,依此类推。
|
||||
|
||||
当奶牛 $i$ 走向 $P_i$ 时,她可能会经过已经有奶牛在进食的牧场。当一头奶牛出现在某个牧场时,奶牛 $i$ 在穿过该牧场时会比平时走得更慢,以避免打扰她的朋友。
|
||||
|
||||
```cpp
|
||||
考虑以下牧场网络,其中括号中的数字表示牧场的主人。
|
||||
|
||||
1 (3)
|
||||
/ \
|
||||
(1) 4 3 (5)
|
||||
/ \
|
||||
(2) 2 5 (4)
|
||||
|
||||
首先,奶牛 1 走向她的牧场:
|
||||
|
||||
1 (3)
|
||||
/ \
|
||||
[1] 4* 3 (5)
|
||||
/ \
|
||||
(2) 2 5 (4)
|
||||
|
||||
当奶牛 2 走向她的牧场时,她首先进入牛棚的牧场,即牧场 1。
|
||||
然后她绕过牧场 4 中的奶牛 1,最终到达自己的牧场。
|
||||
|
||||
1 (3)
|
||||
/ \
|
||||
[1] 4* 3 (5)
|
||||
/ \
|
||||
[2] 2* 5 (4)
|
||||
|
||||
奶牛 3 根本没走远——她在牛棚的牧场 #1 里闲逛。
|
||||
|
||||
1* [3]
|
||||
/ \
|
||||
[1] 4* 3 (5)
|
||||
/ \
|
||||
[2] 2* 5 (4)
|
||||
|
||||
奶牛 4 在前往牧场 5 的路上,必须在牧场 1 和 4 放慢速度:
|
||||
|
||||
1* [3]
|
||||
/ \
|
||||
[1] 4* 3 (5)
|
||||
/ \
|
||||
[2] 2* 5* [4]
|
||||
|
||||
奶牛 5 因为在牧场 1 遇到奶牛 3 而放慢速度,然后进入自己的私人牧场:
|
||||
|
||||
1* [3]
|
||||
/ \
|
||||
[1] 4* 3*[5]
|
||||
/ \
|
||||
[2] 2* 5* [4]
|
||||
```
|
||||
|
||||
FJ 想知道每头奶牛需要放慢多少次速度。
|
||||
|
||||
## 输入格式
|
||||
|
||||
- 第 1 行:一个整数 $N$。
|
||||
- 第 $2..N$ 行:第 $i+1$ 行包含两个以空格分隔的整数 $A_i$ 和 $B_i$。
|
||||
- 第 $N+1..N+N$ 行:第 $N+i$ 行包含一个整数 $P_i$。
|
||||
|
||||
## 输出格式
|
||||
|
||||
- 第 $1..N$ 行:第 $i$ 行包含奶牛 $i$ 需要放慢速度的次数。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
5
|
||||
1 4
|
||||
5 4
|
||||
1 3
|
||||
2 4
|
||||
4
|
||||
2
|
||||
1
|
||||
5
|
||||
3
|
||||
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
0
|
||||
1
|
||||
0
|
||||
2
|
||||
1
|
||||
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
数据范围:$1 \leq A_i, B_i, P_i \leq N \leq 10^5$。
|
||||
@@ -0,0 +1,97 @@
|
||||
#include<bits/stdc++.h>
|
||||
using namespace std;
|
||||
int n, k;
|
||||
vector<int> fri[100005];
|
||||
int cnt[100005];
|
||||
int fa[100005];
|
||||
int son[100005];
|
||||
int dfn[100005];
|
||||
int top[100005];
|
||||
int dep[100005];
|
||||
int nowdfn;
|
||||
struct SEG{
|
||||
int num[400005], lt[400005];
|
||||
void pu(int now) {
|
||||
num[now] = num[now * 2] + num[now * 2 + 1];
|
||||
}
|
||||
void pd(int now, int nl, int nr) {
|
||||
int nmid = (nl + nr) >> 1;
|
||||
int l = lt[now];
|
||||
num[now * 2] += l * (nmid - nl + 1);
|
||||
num[now * 2 + 1] += l * (nr - nmid);
|
||||
lt[now * 2] += l;
|
||||
lt[now * 2 + 1] += l;
|
||||
lt[now] = 0;
|
||||
}
|
||||
void add(int now, int nl, int nr, int l, int r, int nn) {
|
||||
if(nl > r || nr < l) return;
|
||||
if(l <= nl && nr <= r) {
|
||||
num[now] += nn;
|
||||
lt[now] += nn;
|
||||
return;
|
||||
}
|
||||
int nmid = (nl + nr) >> 1;
|
||||
add(now * 2, nl, nmid, l, r, nn);
|
||||
add(now * 2 + 1, nmid + 1, nr, l, r, nn);
|
||||
pu(now);
|
||||
}
|
||||
int query(int now, int nl, int nr, int l, int r) {
|
||||
if(nl > r || nr < l) return 0;
|
||||
if(l <= nl && nr <= r) {
|
||||
return num[now];
|
||||
}
|
||||
int nmid = (nl + nr) >> 1;
|
||||
pd(now, nl, nr);
|
||||
return query(now * 2, nl, nmid, l, r) + query(now * 2 + 1, nmid + 1, nr, l, r);
|
||||
}
|
||||
}seg;
|
||||
void dfs1(int now, int from) {
|
||||
cnt[now] = 1;
|
||||
for(int i : fri[now]) {
|
||||
if(i == from) continue;
|
||||
fa[i] = now;
|
||||
dep[i] = dep[now] + 1;
|
||||
dfs1(i, now);
|
||||
cnt[now] += cnt[i];
|
||||
if(cnt[son[now]] < cnt[i]) son[now] = i;
|
||||
}
|
||||
}
|
||||
void dfs2(int now, int from) {
|
||||
dfn[now] = ++nowdfn;
|
||||
top[now] = from;
|
||||
if(son[now]) dfs2(son[now], from);
|
||||
for(int i : fri[now]) {
|
||||
if(i == fa[now] || i == son[now]) continue;
|
||||
dfs2(i, i);
|
||||
}
|
||||
}
|
||||
void add(int a, int b) {
|
||||
while(top[a] != top[b]) {
|
||||
if(dep[top[a]] < dep[top[b]]) swap(a, b);
|
||||
seg.add(1, 1, n, dfn[top[a]], dfn[a], 1);
|
||||
a = fa[top[a]];
|
||||
}
|
||||
if(dep[a] < dep[b]) swap(a, b);
|
||||
seg.add(1, 1, n, dfn[b], dfn[a], 1);
|
||||
}
|
||||
int main() {
|
||||
scanf("%d%d", &n, &k);
|
||||
for(int i = 1, u, v; i < n; ++i) {
|
||||
scanf("%d%d", &u, &v);
|
||||
fri[u].push_back(v);
|
||||
fri[v].push_back(u);
|
||||
}
|
||||
dfs1(1, -1);
|
||||
dfs2(1, 1);
|
||||
while(k--) {
|
||||
int u, v;
|
||||
scanf("%d%d", &u, &v);
|
||||
add(u, v);
|
||||
}
|
||||
int ans = 0;
|
||||
for(int i = 1; i <= n; ++i) {
|
||||
ans = max(ans, seg.query(1, 1, n, i, i));
|
||||
}
|
||||
printf("%d\n", ans);
|
||||
return 0;
|
||||
}
|
||||
@@ -0,0 +1,51 @@
|
||||
# P3128 [USACO15DEC] Max Flow P
|
||||
|
||||
## 题目描述
|
||||
|
||||
Farmer John 在他的谷仓中安装了 $N-1$ 条管道,用于在 $N$ 个牛棚之间运输牛奶($2 \leq N \leq 50,000$),牛棚方便地编号为 $1 \ldots N$。每条管道连接一对牛棚,所有牛棚通过这些管道相互连接。
|
||||
|
||||
FJ 正在 $K$ 对牛棚之间泵送牛奶($1 \leq K \leq 100,000$)。对于第 $i$ 对牛棚,你被告知两个牛棚 $s_i$ 和 $t_i$,这是牛奶以单位速率泵送的路径的端点。FJ 担心某些牛棚可能会因为过多的牛奶通过它们而不堪重负,因为一个牛棚可能会作为许多泵送路径的中转站。请帮助他确定通过任何一个牛棚的最大牛奶量。如果牛奶沿着从 $s_i$ 到 $t_i$ 的路径泵送,那么它将被计入端点牛棚 $s_i$ 和 $t_i$,以及它们之间路径上的所有牛棚。
|
||||
|
||||
## 输入格式
|
||||
|
||||
输入的第一行包含 $N$ 和 $K$。
|
||||
|
||||
接下来的 $N-1$ 行每行包含两个整数 $x$ 和 $y$($x \ne y$),描述连接牛棚 $x$ 和 $y$ 的管道。
|
||||
|
||||
接下来的 $K$ 行每行包含两个整数 $s$ 和 $t$,描述牛奶泵送路径的端点牛棚。
|
||||
|
||||
## 输出格式
|
||||
|
||||
输出一个整数,表示通过谷仓中任何一个牛棚的最大牛奶量。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
5 10
|
||||
3 4
|
||||
1 5
|
||||
4 2
|
||||
5 4
|
||||
5 4
|
||||
5 4
|
||||
3 5
|
||||
4 3
|
||||
4 3
|
||||
1 3
|
||||
3 5
|
||||
5 4
|
||||
1 5
|
||||
3 4
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
9
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
$2 \le N \le 5 \times 10^4,1 \le K \le 10^5$。
|
||||
@@ -0,0 +1,99 @@
|
||||
#include<bits/stdc++.h>
|
||||
#define int long long
|
||||
using namespace std;
|
||||
int n;
|
||||
int a[300005];
|
||||
int fa[300005];
|
||||
int dfn[300005];
|
||||
int son[300005];
|
||||
int dep[300005];
|
||||
int top[300005];
|
||||
int cnt[300005];
|
||||
vector<int> fri[300005];
|
||||
int dfnnow;
|
||||
struct SEG{
|
||||
int num[1200005], lt[1200005];
|
||||
void pu(int now) {
|
||||
num[now] = num[now * 2] + num[now * 2 + 1];
|
||||
}
|
||||
void pd(int now, int nl, int nr) {
|
||||
int nmid = (nl + nr) >> 1, l = lt[now];
|
||||
num[now * 2] += l * (nmid - nl + 1);
|
||||
num[now * 2 + 1] += l * (nr - nmid);
|
||||
lt[now * 2] += l;
|
||||
lt[now * 2 + 1] += l;
|
||||
lt[now] = 0;
|
||||
}
|
||||
void add(int now, int nl, int nr, int l, int r, int nn) {
|
||||
if(nr < l || nl > r) return;
|
||||
if(l <= nl && nr <= r) {
|
||||
num[now] += (nr - nl + 1) * nn;
|
||||
lt[now] += nn;
|
||||
return;
|
||||
}
|
||||
int nmid = (nl + nr) >> 1;
|
||||
pd(now, nl, nr);
|
||||
add(now * 2, nl, nmid, l, r, nn);
|
||||
add(now * 2 + 1, nmid + 1, nr, l, r, nn);
|
||||
pu(now);
|
||||
}
|
||||
int query(int now, int nl, int nr, int l, int r) {
|
||||
if(nr < l || nl > r) return 0;
|
||||
if(l <= nl && nr <= r) {
|
||||
return num[now];
|
||||
}
|
||||
int nmid = (nl + nr) >> 1;
|
||||
pd(now, nl, nr);
|
||||
return query(now * 2, nl, nmid, l, r) + query(now * 2 + 1, nmid + 1, nr, l, r);
|
||||
}
|
||||
}seg;
|
||||
void dfs1(int now, int from) {
|
||||
cnt[now] = 1;
|
||||
for(int i : fri[now]) {
|
||||
if(i == from) continue;
|
||||
fa[i] = now;
|
||||
dep[i] = dep[now] + 1;
|
||||
dfs1(i, now);
|
||||
cnt[now] += cnt[i];
|
||||
if(cnt[son[now]] < cnt[i]) son[now] = i;
|
||||
}
|
||||
}
|
||||
void dfs2(int now, int from) {
|
||||
top[now] = from;
|
||||
dfn[now] = ++dfnnow;
|
||||
if(son[now]) dfs2(son[now], from);
|
||||
for(int i : fri[now]) {
|
||||
if(i == fa[now] || i == son[now]) continue;
|
||||
dfs2(i, i);
|
||||
}
|
||||
}
|
||||
void edit(int a, int b, int nn = 1) {
|
||||
while(top[a] != top[b]) {
|
||||
if(dep[top[a]] < dep[top[b]]) swap(a, b);
|
||||
seg.add(1, 1, n, dfn[top[a]], dfn[a], nn);
|
||||
a = fa[top[a]];
|
||||
}
|
||||
if(dep[a] < dep[b]) swap(a, b);
|
||||
seg.add(1, 1, n, dfn[b], dfn[a], nn);
|
||||
}
|
||||
signed main() {
|
||||
scanf("%lld", &n);
|
||||
for(int i = 1; i <= n; ++i) {
|
||||
scanf("%lld", &a[i]);
|
||||
}
|
||||
for(int i = 1, u, v; i < n; ++i) {
|
||||
scanf("%lld%lld", &u, &v);
|
||||
fri[u].push_back(v);
|
||||
fri[v].push_back(u);
|
||||
}
|
||||
dfs1(1, -1);
|
||||
dfs2(1, 1);
|
||||
for(int i = 1; i < n; ++i) {
|
||||
edit(a[i], a[i + 1]);
|
||||
edit(a[i + 1], a[i + 1], -1);
|
||||
}
|
||||
for(int i = 1; i <= n; ++i) {
|
||||
printf("%lld\n", seg.query(1, 1, n, dfn[i], dfn[i]));
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
@@ -0,0 +1,48 @@
|
||||
# P3258 [JLOI2014] 松鼠的新家
|
||||
|
||||
## 题目描述
|
||||
|
||||
松鼠的新家是一棵树,前几天刚刚装修了新家,新家有 $n$ 个房间,并且有 $n-1$ 根树枝连接,每个房间都可以相互到达,且两个房间之间的路线都是唯一的。天哪,他居然真的住在“树”上。
|
||||
|
||||
松鼠想邀请小熊维尼前来参观,并且还指定一份参观指南,他希望维尼能够按照他的指南顺序,先去 $a_1$,再去 $a_2$,……,最后到 $a_n$,去参观新家。可是这样会导致重复走很多房间,懒惰的维尼不停地推辞。可是松鼠告诉他,每走到一个房间,他就可以从房间拿一块糖果吃。
|
||||
|
||||
维尼是个馋家伙,立马就答应了。现在松鼠希望知道为了保证维尼有糖果吃,他需要在每一个房间各放至少多少个糖果。
|
||||
|
||||
因为松鼠参观指南上的最后一个房间 $a_n$ 是餐厅,餐厅里他准备了丰盛的大餐,所以当维尼在参观的最后到达餐厅时就不需要再拿糖果吃了。
|
||||
|
||||
## 输入格式
|
||||
|
||||
第一行一个正整数 $n$,表示房间个数。第二行 $n$ 个正整数,依次描述 $a_1, a_2,\cdots,a_n$。
|
||||
|
||||
接下来 $n-1$ 行,每行两个正整数 $x,y$,表示标号 $x$ 和 $y$ 的两个房间之间有树枝相连。
|
||||
|
||||
## 输出格式
|
||||
|
||||
一共 $n$ 行,第 $i$ 行输出标号为 $i$ 的房间至少需要放多少个糖果,才能让维尼有糖果吃。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
5
|
||||
1 4 5 3 2
|
||||
1 2
|
||||
2 4
|
||||
2 3
|
||||
4 5
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
1
|
||||
2
|
||||
1
|
||||
2
|
||||
1
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
对于全部的数据,$2 \le n \le 3 \times 10^5$,$1 \le a_i \le n$。
|
||||
@@ -0,0 +1,34 @@
|
||||
#include<bits/stdc++.h>
|
||||
using namespace std;
|
||||
int n, m;
|
||||
vector<pair<int, pair<int, int>>> fri;
|
||||
int fa[5005];
|
||||
int find(int x) {
|
||||
if(fa[x] == x) return x;
|
||||
return fa[x] = find(fa[x]);
|
||||
}
|
||||
int main() {
|
||||
scanf("%d%d", &n, &m);
|
||||
for(int i = 1; i <= n; ++i) fa[i] = i;
|
||||
for(int i = 1, u, v, w; i <= m; ++i) {
|
||||
scanf("%d%d%d", &u, &v, &w);
|
||||
fri.push_back({w, {u, v}});
|
||||
}
|
||||
sort(fri.begin(), fri.end());
|
||||
long long ans = 0;
|
||||
for(auto i : fri) {
|
||||
if(find(i.second.first) != find(i.second.second)) {
|
||||
ans += i.first;
|
||||
fa[find(i.second.first)] = find(i.second.second);
|
||||
}
|
||||
}
|
||||
int to = find(1);
|
||||
for(int i = 2; i <= n; ++i) {
|
||||
if(find(i) != to) {
|
||||
printf("orz\n");
|
||||
return 0;
|
||||
}
|
||||
}
|
||||
printf("%lld\n", ans);
|
||||
return 0;
|
||||
}
|
||||
@@ -0,0 +1,53 @@
|
||||
# P3366 【模板】最小生成树
|
||||
|
||||
## 题目描述
|
||||
|
||||
如题,给出一个无向图,求出最小生成树,如果该图不连通,则输出 `orz`。
|
||||
|
||||
## 输入格式
|
||||
|
||||
第一行包含两个整数 $N,M$,表示该图共有 $N$ 个结点和 $M$ 条无向边。
|
||||
|
||||
接下来 $M$ 行每行包含三个整数 $X_i,Y_i,Z_i$,表示有一条长度为 $Z_i$ 的无向边连接结点 $X_i,Y_i$。
|
||||
|
||||
## 输出格式
|
||||
|
||||
如果该图连通,则输出一个整数表示最小生成树的各边的长度之和。如果该图不连通则输出 `orz`。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
4 5
|
||||
1 2 2
|
||||
1 3 2
|
||||
1 4 3
|
||||
2 3 4
|
||||
3 4 3
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
7
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
数据规模:
|
||||
|
||||
对于 $20\%$ 的数据,$N\le 5$,$M\le 20$。
|
||||
|
||||
对于 $40\%$ 的数据,$N\le 50$,$M\le 2500$。
|
||||
|
||||
对于 $70\%$ 的数据,$N\le 500$,$M\le 10^4$。
|
||||
|
||||
对于 $100\%$ 的数据:$1\le N\le 5000$,$1\le M\le 2\times 10^5$,$1\le Z_i \le 10^4$,$1\le X_i,Y_i\le N$。
|
||||
|
||||
|
||||
样例解释:
|
||||
|
||||
|
||||
|
||||
所以最小生成树的总边权为 $2+2+3=7$。
|
||||
@@ -0,0 +1,94 @@
|
||||
#include<bits/stdc++.h>
|
||||
using namespace std;
|
||||
struct node {
|
||||
long long sum;
|
||||
long long lt1;
|
||||
long long lt2 = 1;
|
||||
} seg[400005];
|
||||
int n, q;
|
||||
long long m;
|
||||
int a[100005];
|
||||
void pu(int now) {
|
||||
seg[now].sum = (seg[now * 2].sum + seg[now * 2 + 1].sum) % m;
|
||||
}
|
||||
void apply(int now, int len, long long mul, long long add) {
|
||||
seg[now].sum = (seg[now].sum * mul % m + add * len % m) % m;
|
||||
seg[now].lt2 = seg[now].lt2 * mul % m;
|
||||
seg[now].lt1 = (seg[now].lt1 * mul % m + add) % m;
|
||||
}
|
||||
void pd(int now, int nl, int nr) {
|
||||
if (seg[now].lt1 == 0 && seg[now].lt2 == 1) return;
|
||||
int mid = (nl + nr) >> 1;
|
||||
apply(now * 2, mid - nl + 1, seg[now].lt2, seg[now].lt1);
|
||||
apply(now * 2 + 1, nr - mid, seg[now].lt2, seg[now].lt1);
|
||||
seg[now].lt1 = 0;
|
||||
seg[now].lt2 = 1;
|
||||
}
|
||||
|
||||
void init(int now, int nl, int nr) {
|
||||
if (nl == nr) {
|
||||
seg[now].sum = a[nl] % m;
|
||||
return;
|
||||
}
|
||||
int mid = (nl + nr) >> 1;
|
||||
init(now * 2, nl, mid);
|
||||
init(now * 2 + 1, mid + 1, nr);
|
||||
pu(now);
|
||||
}
|
||||
void add(int now, int nl, int nr, int l, int r, long long nn) {
|
||||
if (nl > r || nr < l) return;
|
||||
if (l <= nl && nr <= r) {
|
||||
apply(now, nr - nl + 1, 1, nn % m);
|
||||
return;
|
||||
}
|
||||
int mid = (nl + nr) >> 1;
|
||||
pd(now, nl, nr);
|
||||
add(now * 2, nl, mid, l, r, nn);
|
||||
add(now * 2 + 1, mid + 1, nr, l, r, nn);
|
||||
pu(now);
|
||||
}
|
||||
void mul(int now, int nl, int nr, int l, int r, long long nn) {
|
||||
if (nl > r || nr < l) return;
|
||||
if (l <= nl && nr <= r) {
|
||||
apply(now, nr - nl + 1, nn % m, 0);
|
||||
return;
|
||||
}
|
||||
int mid = (nl + nr) >> 1;
|
||||
pd(now, nl, nr);
|
||||
mul(now * 2, nl, mid, l, r, nn);
|
||||
mul(now * 2 + 1, mid + 1, nr, l, r, nn);
|
||||
pu(now);
|
||||
}
|
||||
long long query(int now, int nl, int nr, int l, int r) {
|
||||
if (nl > r || nr < l) return 0;
|
||||
if (l <= nl && nr <= r) {
|
||||
return seg[now].sum % m;
|
||||
}
|
||||
int mid = (nl + nr) >> 1;
|
||||
pd(now, nl, nr);
|
||||
return (query(now * 2, nl, mid, l, r) + query(now * 2 + 1, mid + 1, nr, l, r)) % m;
|
||||
}
|
||||
int main() {
|
||||
scanf("%d%d%lld", &n, &q, &m);
|
||||
for (int i = 1; i <= n; ++i) {
|
||||
scanf("%d", &a[i]);
|
||||
}
|
||||
init(1, 1, n);
|
||||
while (q--) {
|
||||
int op, x, y;
|
||||
scanf("%d%d%d", &op, &x, &y);
|
||||
if (op == 1) {
|
||||
long long k;
|
||||
scanf("%lld", &k);
|
||||
mul(1, 1, n, x, y, k);
|
||||
} else if (op == 2) {
|
||||
long long k;
|
||||
scanf("%lld", &k);
|
||||
add(1, 1, n, x, y, k);
|
||||
} else {
|
||||
printf("%lld\n", query(1, 1, n, x, y));
|
||||
}
|
||||
}
|
||||
|
||||
return 0;
|
||||
}
|
||||
@@ -0,0 +1,66 @@
|
||||
# P3373 【模板】线段树 2
|
||||
|
||||
## 题目描述
|
||||
|
||||
如题,已知一个数列 $a$,你需要进行下面三种操作:
|
||||
|
||||
- 将某区间每一个数乘上 $x$;
|
||||
- 将某区间每一个数加上 $x$;
|
||||
- 求出某区间每一个数的和。
|
||||
|
||||
## 输入格式
|
||||
|
||||
第一行包含三个整数 $n,q,m$,分别表示该数列数字的个数、操作的总个数和模数。
|
||||
|
||||
第二行包含 $n$ 个用空格分隔的整数,其中第 $i$ 个数字表示数列第 $i$ 项的初始值 $a_i$。
|
||||
|
||||
接下来 $q$ 行每行包含若干个整数,表示一个操作,具体如下:
|
||||
|
||||
操作 $1$: 格式:`1 x y k` 含义:将区间 $[x,y]$ 内每个数乘上 $k$。
|
||||
|
||||
操作 $2$: 格式:`2 x y k` 含义:将区间 $[x,y]$ 内每个数加上 $k$。
|
||||
|
||||
操作 $3$: 格式:`3 x y` 含义:输出区间 $[x,y]$ 内每个数的和对 $m$ 取模所得的结果。
|
||||
|
||||
## 输出格式
|
||||
|
||||
输出包含若干行整数,即为所有操作 $3$ 的结果。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
5 5 38
|
||||
1 5 4 2 3
|
||||
2 1 4 1
|
||||
3 2 5
|
||||
1 2 4 2
|
||||
2 3 5 5
|
||||
3 1 4
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
17
|
||||
2
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
【数据范围】
|
||||
|
||||
对于 $30\%$ 的数据:$n \le 8$,$q \le 10$。
|
||||
对于 $70\%$ 的数据:$n \le 10^3 $,$q \le 10^4$。
|
||||
对于 $100\%$ 的数据:$1 \le n \le 10^5$,$1 \le q \le 10^5,1\le a_i,k\le 10^4$。
|
||||
|
||||
除样例外,$m = 571373$。
|
||||
|
||||
(数据已经过加强 ^\_^)
|
||||
|
||||
样例说明:
|
||||
|
||||
|
||||
|
||||
故输出应为 $17$、$2$($40 \bmod 38 = 2$)。
|
||||
@@ -0,0 +1,55 @@
|
||||
#include<bits/stdc++.h>
|
||||
using namespace std;
|
||||
int n, m, s;
|
||||
vector<int> fri[500005];
|
||||
int dep[500005];
|
||||
int fa[500005];
|
||||
int son[500005];
|
||||
int cnt[500005];
|
||||
int dfn[500005];
|
||||
int top[500005];
|
||||
int nowdfn;
|
||||
void dfs1(int now, int from) {
|
||||
dfn[now] = ++nowdfn;
|
||||
cnt[now] = 1;
|
||||
dep[now] = dep[fa[now]] + 1;
|
||||
for(int i : fri[now]) {
|
||||
if(i == from) continue;
|
||||
fa[i] = now;
|
||||
dfs1(i, now);
|
||||
cnt[now] += cnt[i];
|
||||
if(cnt[son[now]] < cnt[i]) son[now] = i;
|
||||
}
|
||||
}
|
||||
void dfs2(int now, int from) {
|
||||
top[now] = from;
|
||||
if(son[now]) dfs2(son[now], from);
|
||||
for(int i : fri[now]) {
|
||||
if(i == fa[now] || i == son[now]) continue;
|
||||
dfs2(i, i);
|
||||
}
|
||||
}
|
||||
int lca(int a, int b) {
|
||||
while(top[a] != top[b]) {
|
||||
if(dep[top[a]] < dep[top[b]]) swap(a, b);
|
||||
a = fa[top[a]];
|
||||
}
|
||||
if(dep[a] < dep[b]) swap(a, b);
|
||||
return b;
|
||||
}
|
||||
int main() {
|
||||
scanf("%d%d%d", &n, &m, &s);
|
||||
for(int i = 1, u, v; i < n; ++i) {
|
||||
scanf("%d%d", &u, &v);
|
||||
fri[u].push_back(v);
|
||||
fri[v].push_back(u);
|
||||
}
|
||||
dfs1(s, -1);
|
||||
dfs2(s, s);
|
||||
while(m--) {
|
||||
int a, b;
|
||||
scanf("%d%d", &a, &b);
|
||||
printf("%d\n", lca(a, b));
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
@@ -0,0 +1,75 @@
|
||||
# P3379 【模板】最近公共祖先(LCA)
|
||||
|
||||
## 题目描述
|
||||
|
||||
如题,给定一棵有根多叉树,请求出指定两个点之间最近的公共祖先。
|
||||
|
||||
## 输入格式
|
||||
|
||||
第一行包含三个正整数 $N,M,S$,分别表示树的结点个数、询问的个数和树根结点的序号。
|
||||
|
||||
接下来 $N-1$ 行每行包含两个正整数 $x, y$,表示 $x$ 结点和 $y$ 结点之间有一条直接连接的边(数据保证可以构成树)。
|
||||
|
||||
接下来 $M$ 行每行包含两个正整数 $a, b$,表示询问 $a$ 结点和 $b$ 结点的最近公共祖先。
|
||||
|
||||
## 输出格式
|
||||
|
||||
输出包含 $M$ 行,每行包含一个正整数,依次为每一个询问的结果。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
5 5 4
|
||||
3 1
|
||||
2 4
|
||||
5 1
|
||||
1 4
|
||||
2 4
|
||||
3 2
|
||||
3 5
|
||||
1 2
|
||||
4 5
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
4
|
||||
4
|
||||
1
|
||||
4
|
||||
4
|
||||
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
对于 $30\%$ 的数据,$N\leq 10$,$M\leq 10$。
|
||||
|
||||
对于 $70\%$ 的数据,$N\leq 10000$,$M\leq 10000$。
|
||||
|
||||
对于 $100\%$ 的数据,$1 \leq N,M\leq 5\times10^5$,$1 \leq x, y,a ,b \leq N$,**不保证** $a \neq b$。
|
||||
|
||||
|
||||
样例说明:
|
||||
|
||||
该树结构如下:
|
||||
|
||||
|
||||
|
||||
第一次询问:$2, 4$ 的最近公共祖先,故为 $4$。
|
||||
|
||||
第二次询问:$3, 2$ 的最近公共祖先,故为 $4$。
|
||||
|
||||
第三次询问:$3, 5$ 的最近公共祖先,故为 $1$。
|
||||
|
||||
第四次询问:$1, 2$ 的最近公共祖先,故为 $4$。
|
||||
|
||||
第五次询问:$4, 5$ 的最近公共祖先,故为 $4$。
|
||||
|
||||
故输出依次为 $4, 4, 1, 4, 4$。
|
||||
|
||||
|
||||
2021/10/4 数据更新 @fstqwq:应要求加了两组数据卡掉了暴力跳。
|
||||
@@ -0,0 +1,125 @@
|
||||
#include<bits/stdc++.h>
|
||||
using namespace std;
|
||||
int n, m, r, p;
|
||||
int a[100005];
|
||||
vector<int> fri[100005];
|
||||
int dep[100005];
|
||||
int cnt[100005];
|
||||
int fa[100005];
|
||||
int son[100005];
|
||||
int top[100005];
|
||||
int dfn[100005];
|
||||
int nowdfn = 0;
|
||||
struct seg{
|
||||
int num[400005], lt[400005];
|
||||
void pu(int now) {
|
||||
num[now] = (num[now * 2] + num[now * 2 + 1]) % p;
|
||||
}
|
||||
void pd(int now, int nl, int nr) {
|
||||
int l = lt[now], nmid = (nl + nr) >> 1;
|
||||
num[now * 2] = (1ll * num[now * 2] + l * (nmid - nl + 1)) % p;
|
||||
num[now * 2 + 1] = (1ll * num[now * 2 + 1] + l * (nr - nmid)) % p;
|
||||
lt[now * 2] = (lt[now * 2] + l) % p;
|
||||
lt[now * 2 + 1] = (lt[now * 2 + 1] + l) % p;
|
||||
lt[now] = 0;
|
||||
}
|
||||
void add(int now, int nl, int nr, int l, int r, int nn) {
|
||||
if(nl > r || nr < l) return;
|
||||
if(l <= nl && nr <= r) {
|
||||
num[now] = (1ll * (nn) * (nr - nl + 1) + num[now]) % p;
|
||||
lt[now] = (lt[now] + nn) % p;
|
||||
return;
|
||||
}
|
||||
int nmid = (nl + nr) >> 1;
|
||||
pd(now, nl, nr);
|
||||
add(now * 2, nl, nmid, l, r, nn);
|
||||
add(now * 2 + 1, nmid + 1, nr, l, r, nn);
|
||||
pu(now);
|
||||
}
|
||||
int query(int now, int nl, int nr, int l, int r) {
|
||||
if(nl > r || nr < l) return 0;
|
||||
if(l <= nl && nr <= r) {
|
||||
return num[now] % p;
|
||||
}
|
||||
int nmid = (nl + nr) >> 1;
|
||||
pd(now, nl, nr);
|
||||
return (query(now * 2, nl, nmid, l, r) + query(now * 2 + 1, nmid + 1, nr, l, r)) % p;
|
||||
}
|
||||
}seg;
|
||||
void dfs1(int now, int from) {
|
||||
cnt[now] = 1;
|
||||
for(int i : fri[now]) {
|
||||
if(i == from) continue;
|
||||
fa[i] = now;
|
||||
dep[i] = dep[now] + 1;
|
||||
dfs1(i, now);
|
||||
cnt[now] += cnt[i];
|
||||
if(cnt[i] > cnt[son[now]]) son[now] = i;
|
||||
}
|
||||
}
|
||||
void dfs2(int now, int from) {
|
||||
dfn[now] = ++nowdfn;
|
||||
top[now] = from;
|
||||
// bit.add(nowdfn, nowdfn, a[now]);
|
||||
seg.add(1, 1, n, nowdfn, nowdfn, a[now]);
|
||||
if(son[now])
|
||||
dfs2(son[now], top[now]);
|
||||
for(int i : fri[now]) {
|
||||
if(i == fa[now] || i == son[now]) continue;
|
||||
dfs2(i, i);
|
||||
}
|
||||
}
|
||||
void pathadd(int x, int y, int nn) {
|
||||
while(top[x] != top[y]) {
|
||||
if(dep[top[x]] < dep[top[y]]) swap(x, y);
|
||||
seg.add(1, 1, n, dfn[top[x]], dfn[x], nn);
|
||||
x = fa[top[x]];
|
||||
}
|
||||
if(dep[x] < dep[y]) swap(x, y);
|
||||
seg.add(1, 1, n, dfn[y], dfn[x], nn);
|
||||
}
|
||||
int query(int x, int y) {
|
||||
int ans = 0;
|
||||
while(top[x] != top[y]) {
|
||||
if(dep[top[x]] < dep[top[y]]) swap(x, y);
|
||||
ans = (ans + seg.query(1, 1, n, dfn[top[x]], dfn[x])) % p;
|
||||
x = fa[top[x]];
|
||||
}
|
||||
if(dep[x] < dep[y]) swap(x, y);
|
||||
return (ans + seg.query(1, 1, n, dfn[y], dfn[x])) % p;
|
||||
}
|
||||
void adds(int x, int nn) {
|
||||
seg.add(1, 1, n, dfn[x], dfn[x] + cnt[x] - 1, nn);
|
||||
}
|
||||
int querys(int x) {
|
||||
return seg.query(1, 1, n, dfn[x], dfn[x] + cnt[x] - 1) % p;
|
||||
}
|
||||
int main() {
|
||||
scanf("%d%d%d%d", &n, &m, &r, &p);
|
||||
for(int i = 1; i <= n; ++i) scanf("%d", &a[i]);
|
||||
for(int i = 1, u, v; i < n; ++i) {
|
||||
scanf("%d%d", &u, &v);
|
||||
fri[u].push_back(v);
|
||||
fri[v].push_back(u);
|
||||
}
|
||||
dfs1(r, -1);
|
||||
dfs2(r, r);
|
||||
while(m--) {
|
||||
int op, x, y, z;
|
||||
scanf("%d", &op);
|
||||
if(op == 1) {
|
||||
scanf("%d%d%d", &x, &y, &z);
|
||||
pathadd(x, y, z);
|
||||
} else if(op ==2) {
|
||||
scanf("%d%d", &x, &y);
|
||||
printf("%d\n", query(x, y));
|
||||
} else if(op == 3) {
|
||||
scanf("%d%d", &x, &z);
|
||||
adds(x, z);
|
||||
} else {
|
||||
scanf("%d", &x);
|
||||
printf("%d\n", querys(x));
|
||||
}
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
@@ -0,0 +1,74 @@
|
||||
# P3384 【模板】重链剖分 / 树链剖分
|
||||
|
||||
## 题目描述
|
||||
|
||||
如题,已知一棵包含 $N$ 个结点的树(连通且无环),每个节点上包含一个数值,需要支持以下操作:
|
||||
|
||||
- `1 x y z`,表示将树从 $x$ 到 $y$ 结点最短路径上所有节点的值都加上 $z$。
|
||||
|
||||
- `2 x y`,表示求树从 $x$ 到 $y$ 结点最短路径上所有节点的值之和。
|
||||
|
||||
- `3 x z`,表示将以 $x$ 为根节点的子树内所有节点值都加上 $z$。
|
||||
|
||||
- `4 x`,表示求以 $x$ 为根节点的子树内所有节点值之和。
|
||||
|
||||
## 输入格式
|
||||
|
||||
第一行包含 $4$ 个正整数 $N,M,R,P$,分别表示树的结点个数、操作个数、根节点序号和取模数(**即所有的输出结果均对此取模**)。
|
||||
|
||||
接下来一行包含 $N$ 个非负整数,分别依次表示各个节点上初始的数值。
|
||||
|
||||
接下来 $N-1$ 行每行包含两个整数 $x,y$,表示点 $x$ 和点 $y$ 之间连有一条边(保证无环且连通)。
|
||||
|
||||
接下来 $M$ 行每行包含若干个正整数,每行表示一个操作。
|
||||
|
||||
## 输出格式
|
||||
|
||||
输出包含若干行,分别依次表示每个操作 $2$ 或操作 $4$ 所得的结果(**对 $P$ 取模**)。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
5 5 2 24
|
||||
7 3 7 8 0
|
||||
1 2
|
||||
1 5
|
||||
3 1
|
||||
4 1
|
||||
3 4 2
|
||||
3 2 2
|
||||
4 5
|
||||
1 5 1 3
|
||||
2 1 3
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
2
|
||||
21
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
**【数据规模】**
|
||||
|
||||
对于 $30\%$ 的数据: $1 \leq N \leq 10$,$1 \leq M \leq 10$;
|
||||
|
||||
对于 $70\%$ 的数据: $1 \leq N \leq {10}^3$,$1 \leq M \leq {10}^3$;
|
||||
|
||||
对于 $100\%$ 的数据: $1\le N \leq {10}^5$,$1\le M \leq {10}^5$,$1\le R\le N$,$1\le P \le 2^{30}$。所有输入的数均在 `int` 范围内。
|
||||
|
||||
**【样例说明】**
|
||||
|
||||
树的结构如下:
|
||||
|
||||
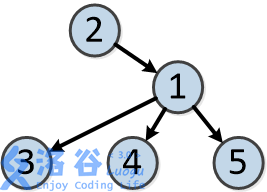
|
||||
|
||||
各个操作如下:
|
||||
|
||||
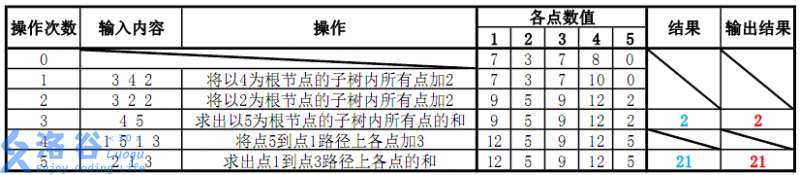
|
||||
|
||||
故输出应依次为 $2$ 和 $21$。
|
||||
@@ -0,0 +1,73 @@
|
||||
#include<bits/stdc++.h>
|
||||
using namespace std;
|
||||
int n, q;
|
||||
vector<int> fri[100005];
|
||||
int fa[100005];
|
||||
int dep[100005];
|
||||
int top[100005];
|
||||
int son[100005];
|
||||
int cnt[100005];
|
||||
void dfs1(int now, int from) {
|
||||
cnt[now] = 1;
|
||||
for(int i : fri[now]) {
|
||||
if(i == from) continue;
|
||||
fa[i] = now;
|
||||
dep[i] = dep[now] + 1;
|
||||
dfs1(i, now);
|
||||
cnt[now] += cnt[i];
|
||||
if(cnt[son[now]] < cnt[i]) son[now] = i;
|
||||
}
|
||||
}
|
||||
void dfs2(int now, int from) {
|
||||
top[now] = from;
|
||||
if(son[now]) dfs2(son[now], from);
|
||||
for(int i : fri[now]) {
|
||||
if(i == fa[now] || i == son[now]) continue;
|
||||
dfs2(i, i);
|
||||
}
|
||||
}
|
||||
int lca(int a, int b) {
|
||||
while(top[a] != top[b]) {
|
||||
if(dep[top[a]] < dep[top[b]]) swap(a, b);
|
||||
a = fa[top[a]];
|
||||
}
|
||||
if(dep[a] < dep[b]) swap(a, b);
|
||||
return b;
|
||||
}
|
||||
int main() {
|
||||
scanf("%d%d", &n, &q);
|
||||
for(int i = 1, u, v; i < n; ++i) {
|
||||
scanf("%d%d", &u, &v);
|
||||
fri[u].push_back(v);
|
||||
fri[v].push_back(u);
|
||||
}
|
||||
dfs1(1, 0);
|
||||
dfs2(1, 1);
|
||||
while(q--) {
|
||||
int a, b, c, d;
|
||||
scanf("%d%d%d%d", &a, &b, &c, &d);
|
||||
int lca1 = lca(a, b);
|
||||
int lca2 = lca(c, d);
|
||||
// lca1 在 [c, d] 上或 lca2 在 [a, b] 上
|
||||
if(dep[lca2] >= dep[lca1]) {
|
||||
if(lca(a, lca2) == lca2 || lca(b, lca2) == lca2) {
|
||||
printf("Y\n");
|
||||
} else {
|
||||
printf("N\n");
|
||||
}
|
||||
} else {
|
||||
if(lca(c, lca1) == lca1 || lca(d, lca1) == lca1) {
|
||||
printf("Y\n");
|
||||
} else {
|
||||
printf("N\n");
|
||||
}
|
||||
}
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
/*
|
||||
- deep[x]>=deep[LCA(s,t)]
|
||||
|
||||
- LCA(s,x)=x或LCA(t,x)=x;
|
||||
|
||||
*/
|
||||
@@ -0,0 +1,60 @@
|
||||
# P3398 仓鼠找 sugar
|
||||
|
||||
## 题目描述
|
||||
|
||||
小仓鼠的和他的基(mei)友(zi)sugar 住在地下洞穴中,每个节点的编号为 $1\sim n$。地下洞穴是一个树形结构。这一天小仓鼠打算从从他的卧室($a$)到餐厅($b$),而他的基友同时要从他的卧室($c$)到图书馆($d$)。他们都会走最短路径。现在小仓鼠希望知道,有没有可能在某个地方,可以碰到他的基友?
|
||||
|
||||
|
||||
小仓鼠那么弱,还要天天被 zzq 大爷虐,请你快来救救他吧!
|
||||
|
||||
## 输入格式
|
||||
|
||||
第一行两个正整数 $n$ 和 $q$,表示这棵树节点的个数和询问的个数。
|
||||
|
||||
接下来 $n-1$ 行,每行两个正整数 $u$ 和 $v$,表示节点 $u$ 到节点 $v$ 之间有一条边。
|
||||
|
||||
接下来 $q$ 行,每行四个正整数 $a$、$b$、$c$ 和 $d$,表示节点编号,也就是一次询问,其意义如上。
|
||||
|
||||
## 输出格式
|
||||
|
||||
对于每个询问,如果有公共点,输出大写字母 `Y`;否则输出`N`。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
5 5
|
||||
2 5
|
||||
4 2
|
||||
1 3
|
||||
1 4
|
||||
5 1 5 1
|
||||
2 2 1 4
|
||||
4 1 3 4
|
||||
3 1 1 5
|
||||
3 5 1 4
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
Y
|
||||
N
|
||||
Y
|
||||
Y
|
||||
Y
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
**本题时限 1s,内存限制 128M,因新评测机速度较为接近 NOIP 评测机速度,请注意常数问题带来的影响。**
|
||||
|
||||
|
||||
$20\%$ 的数据 $n, q\le200$。
|
||||
|
||||
$40\%$ 的数据 $n, q\le 2\times10^3$。
|
||||
|
||||
$70\%$ 的数据 $n, q\le 5\times10^4$。
|
||||
|
||||
$100\%$ 的数据 $1\le n, q\le10^5$。
|
||||
@@ -0,0 +1,36 @@
|
||||
#include<bits/stdc++.h>
|
||||
using namespace std;
|
||||
long long n, p;
|
||||
long long mul[3000005];
|
||||
long long revs[3000005];
|
||||
long long rev[3000005];
|
||||
long long qpow(long long a, long long b) {
|
||||
a %= p;
|
||||
long long res = 1;
|
||||
while(b) {
|
||||
if(b & 1) {
|
||||
res = (res * a) % p;
|
||||
}
|
||||
a = (a * a) % p;
|
||||
b >>= 1;
|
||||
}
|
||||
return res;
|
||||
}
|
||||
int main() {
|
||||
scanf("%lld%lld", &n, &p);
|
||||
mul[0] = 1;
|
||||
for(int i = 1; i <= n; ++i) {
|
||||
mul[i] = (mul[i - 1] * i) % p;
|
||||
}
|
||||
revs[n] = qpow(mul[n], p - 2);
|
||||
for(int i = n - 1; i >= 1; --i) {
|
||||
revs[i] = ((i + 1) * revs[i + 1]) % p;
|
||||
}
|
||||
for(int i = 1; i <= n; ++i) {
|
||||
rev[i] = (mul[i - 1] * revs[i]) % p;
|
||||
}
|
||||
for(int i = 1; i <= n; ++i) {
|
||||
printf("%lld\n", rev[i]);
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
@@ -0,0 +1,48 @@
|
||||
# P3811 【模板】模意义下的乘法逆元
|
||||
|
||||
## 题目背景
|
||||
|
||||
这是一道模板题。
|
||||
|
||||
## 题目描述
|
||||
|
||||
给定正整数 $n,p$,求 $[1,n]$ 中所有整数在模 $p$ 意义下的乘法逆元。
|
||||
|
||||
$a$ 模 $p$ 的乘法逆元定义为 $ax\equiv1\pmod p$ 的解。
|
||||
|
||||
## 输入格式
|
||||
|
||||
一行两个正整数 $n,p$。
|
||||
|
||||
## 输出格式
|
||||
|
||||
输出 $n$ 行,其中第 $i$ 行表示 $i$ 在模 $p$ 下的乘法逆元。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
10 13
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
1
|
||||
7
|
||||
9
|
||||
10
|
||||
8
|
||||
11
|
||||
2
|
||||
5
|
||||
3
|
||||
4
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
所有数据满足 $ 1 \leq n \leq 3 \times 10 ^ 6$,$n < p < 20000528 $。
|
||||
|
||||
输入保证 $ p $ 为质数。
|
||||
@@ -0,0 +1,122 @@
|
||||
#include<bits/stdc++.h>
|
||||
const int mod = 201314;
|
||||
using namespace std;
|
||||
int n, m;
|
||||
vector<int> chi[50005];
|
||||
int fa[50005];
|
||||
int cnt[50005];
|
||||
int son[50005];
|
||||
int top[50005];
|
||||
int dep[50005];
|
||||
int dfn[50005];
|
||||
int nowdfn;
|
||||
pair<int, int> query[100005];
|
||||
struct SEG{
|
||||
int num[400005], lt[400005];
|
||||
void pu(int now) {num[now] = (1ll * num[now * 2] + num[now * 2 + 1]) % mod;}
|
||||
void pd(int now, int nl, int nr) {
|
||||
int nmid = (nl + nr) >> 1;
|
||||
num[now * 2] = (num[now * 2] + 1ll * (nmid - nl + 1) * lt[now]) % mod;
|
||||
num[now * 2 + 1] = (num[now * 2 + 1] + 1ll * (nr - nmid) * lt[now]) % mod;
|
||||
lt[now * 2] = (lt[now * 2] + lt[now]) % mod;
|
||||
lt[now * 2 + 1] = (lt[now * 2 + 1] + lt[now]) % mod;
|
||||
lt[now] = 0;
|
||||
}
|
||||
void add(int now, int nl, int nr, int l, int r, int nn) {
|
||||
if(nl > r || nr < l) return;
|
||||
if(l <= nl && nr <= r) {
|
||||
num[now] = (num[now] + 1ll * (nr - nl + 1) * nn) % mod;
|
||||
lt[now] = (lt[now] + 1ll * nn) % mod;
|
||||
return;
|
||||
}
|
||||
int nmid = (nl + nr) >> 1;
|
||||
pd(now, nl, nr);
|
||||
add(now * 2, nl, nmid, l, r, nn);
|
||||
add(now * 2 + 1, nmid + 1, nr, l, r, nn);
|
||||
pu(now);
|
||||
}
|
||||
int query(int now, int nl, int nr, int l, int r) {
|
||||
if(nl > r || nr < l) return 0;
|
||||
if(l <= nl && nr <= r) {
|
||||
return num[now];
|
||||
}
|
||||
int nmid = (nl + nr) >> 1;
|
||||
pd(now, nl, nr);
|
||||
return (1ll * query(now * 2, nl, nmid, l, r) + query(now * 2 + 1, nmid + 1, nr, l, r)) % mod;
|
||||
}
|
||||
}seg;
|
||||
void dfs1(int now) {
|
||||
cnt[now] = 1;
|
||||
for(int i : chi[now]) {
|
||||
dep[i] = dep[now] + 1;
|
||||
dfs1(i);
|
||||
cnt[now] += cnt[i];
|
||||
if(cnt[son[now]] < cnt[i]) son[now] = i;
|
||||
}
|
||||
}
|
||||
void dfs2(int now, int from) {
|
||||
top[now] = from;
|
||||
dfn[now] = ++nowdfn;
|
||||
if(son[now]) dfs2(son[now], from);
|
||||
for(int i : chi[now]) {
|
||||
if(i == son[now]) continue;
|
||||
dfs2(i, i);
|
||||
}
|
||||
}
|
||||
void addpath(int a, int b = 1) {
|
||||
while(top[a] != top[b]) {
|
||||
if(dep[top[a]] < dep[top[b]]) swap(a, b);
|
||||
seg.add(1, 1, n, dfn[top[a]], dfn[a], 1);
|
||||
a = fa[top[a]];
|
||||
}
|
||||
if(dep[a] < dep[b]) swap(a, b);
|
||||
seg.add(1, 1, n, dfn[b], dfn[a], 1);
|
||||
}
|
||||
int querypath(int a, int b = 1) {
|
||||
int ans = 0;
|
||||
while(top[a] != top[b]) {
|
||||
if(dep[top[a]] < dep[top[b]]) swap(a, b);
|
||||
ans = (ans + 1ll * seg.query(1, 1, n, dfn[top[a]], dfn[a])) % mod;
|
||||
a = fa[top[a]];
|
||||
}
|
||||
if(dep[a] < dep[b]) swap(a, b);
|
||||
return (ans + 1ll * seg.query(1, 1, n, dfn[b], dfn[a])) % mod;
|
||||
}
|
||||
int sx[100005];
|
||||
int ans[100005];
|
||||
int main() {
|
||||
scanf("%d%d", &n, &m);
|
||||
for(int i = 2; i <= n; ++i) {
|
||||
scanf("%d", &fa[i]);
|
||||
fa[i]++;
|
||||
chi[fa[i]].push_back(i);
|
||||
}
|
||||
dfs1(1);
|
||||
dfs2(1, 1);
|
||||
for(int i = 1, l, r, z; i <= m; ++i) {
|
||||
scanf("%d%d%d", &l, &r, &z);
|
||||
l++, r++, z++;
|
||||
sx[i] = i;
|
||||
sx[i + m] = i + m;
|
||||
query[2 * i - 1] = {l - 1, z};
|
||||
query[2 * i] = {r, z};
|
||||
}
|
||||
sort(sx + 1, sx + 2 * m + 1, [](int x, int y){return query[x] < query[y];});
|
||||
int cur = 0;
|
||||
for(int i = 1; i <= 2 * m; ++i) {
|
||||
int u = query[sx[i]].first;
|
||||
int w = query[sx[i]].second;
|
||||
while(cur < u) {
|
||||
++cur;
|
||||
addpath(cur);
|
||||
}
|
||||
ans[sx[i]] = querypath(w);
|
||||
}
|
||||
for(int i = 1; i <= m; ++i) {
|
||||
printf("%d\n", (ans[2 * i] - ans[2 * i - 1] + mod) % mod);
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
/*
|
||||
从根到 [l, r] 中每个点的路径上的点均 + 1,最否求 z 到根的路径权值和
|
||||
*/
|
||||
@@ -0,0 +1,54 @@
|
||||
# P4211 [LNOI2014] LCA
|
||||
|
||||
## 题目描述
|
||||
|
||||
给出一个 $n$ 个节点的有根树(编号为 $0$ 到 $n-1$,根节点为 $0$)。
|
||||
|
||||
一个点的深度定义为这个节点到根的距离 $+1$。
|
||||
|
||||
设 $dep[i]$ 表示点 $i$ 的深度,$\operatorname{LCA}(i, j)$ 表示 $i$ 与 $j$ 的最近公共祖先。
|
||||
|
||||
有 $m$ 次询问,每次询问给出 $l, r, z$,求 $\sum_{i=l}^r dep[\operatorname{LCA}(i,z)]$ 。
|
||||
|
||||
## 输入格式
|
||||
|
||||
第一行 $2$ 个整数,$n, m$。
|
||||
|
||||
接下来 $n-1$ 行,分别表示点 $1$ 到点 $n-1$ 的父节点编号。
|
||||
|
||||
接下来 $m$ 行,每行 $3$ 个整数,$l, r, z$。
|
||||
|
||||
## 输出格式
|
||||
|
||||
输出 $m$ 行,每行表示一个询问的答案。每个答案对 $201314$ 取模输出。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
5 2
|
||||
0
|
||||
0
|
||||
1
|
||||
1
|
||||
1 4 3
|
||||
1 4 2
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
8
|
||||
5
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
### 数据范围及约定
|
||||
|
||||
- 对于 $20\%$ 的数据,$n\le 10000,m\le 10000$;
|
||||
- 对于 $40\%$ 的数据,$n\le 20000,m\le 20000$;
|
||||
- 对于 $60\%$ 的数据,$n\le 30000,m\le 30000$;
|
||||
- 对于 $80\%$ 的数据,$n\le 40000,m\le 40000$;
|
||||
- 对于 $100\%$ 的数据,$1\le n\le 50000,1\le m\le 50000$。
|
||||
@@ -0,0 +1,60 @@
|
||||
#include<bits/stdc++.h>
|
||||
using namespace std;
|
||||
int n, m;
|
||||
vector<int> fri[500005];
|
||||
int fa[500005];
|
||||
int dep[500005];
|
||||
int top[500005];
|
||||
int son[500005];
|
||||
int cnt[500005];
|
||||
void dfs1(int now, int from) {
|
||||
cnt[now] = 1;
|
||||
for(int i : fri[now]) {
|
||||
if(i == from) continue;
|
||||
fa[i] = now;
|
||||
dep[i] = dep[now] + 1;
|
||||
dfs1(i, now);
|
||||
cnt[now] += cnt[i];
|
||||
if(cnt[son[now]] < cnt[i]) son[now] = i;
|
||||
}
|
||||
}
|
||||
void dfs2(int now, int from) {
|
||||
top[now] = from;
|
||||
if(son[now]) dfs2(son[now], from);
|
||||
for(int i : fri[now]) {
|
||||
if(i == fa[now] || i == son[now]) continue;
|
||||
dfs2(i, i);
|
||||
}
|
||||
}
|
||||
int lca(int a, int b) {
|
||||
while(top[a] != top[b]) {
|
||||
if(dep[top[a]] < dep[top[b]]) swap(a, b);
|
||||
a = fa[top[a]];
|
||||
}
|
||||
if(dep[a] < dep[b]) swap(a, b);
|
||||
return b;
|
||||
}
|
||||
int main() {
|
||||
scanf("%d%d", &n, &m);
|
||||
for(int i = 1, u, v; i < n; ++i) {
|
||||
scanf("%d%d", &u, &v);
|
||||
fri[u].push_back(v);
|
||||
fri[v].push_back(u);
|
||||
}
|
||||
dfs1(1, 0);
|
||||
dfs2(1, 1);
|
||||
while(m--) {
|
||||
int x, y, z;
|
||||
scanf("%d%d%d", &x, &y, &z);
|
||||
int l1 = lca(x, y), l2 = lca(x, z), l3 = lca(y, z);
|
||||
int mind = min({dep[l1], dep[l2], dep[l3]});
|
||||
int maxd = max({dep[l1], dep[l2], dep[l3]});
|
||||
if(l1 == l2)
|
||||
printf("%d %d\n", l3, dep[x] + dep[y] + dep[z] - 2 * mind - maxd);
|
||||
else if(l1 == l3)
|
||||
printf("%d %d\n", l2, dep[x] + dep[y] + dep[z] - 2 * mind - maxd);
|
||||
else
|
||||
printf("%d %d\n", l1, dep[x] + dep[y] + dep[z] - 2 * mind - maxd);
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
@@ -0,0 +1,53 @@
|
||||
# P4281 [AHOI2008] 紧急集合 / 聚会
|
||||
|
||||
## 题目描述
|
||||
|
||||
欢乐岛上有个非常好玩的游戏,叫做“紧急集合”。在岛上分散有 $n$ 个等待点,有 $n-1$ 条道路连接着它们,每一条道路都连接某两个等待点,且通过这些道路可以走遍所有的等待点,通过道路从一个点到另一个点要花费一个游戏币。
|
||||
|
||||
参加游戏的人三人一组,开始的时候,所有人员均任意分散在各个等待点上(每个点同时允许多个人等待),每个人均带有足够多的游戏币(用于支付使用道路的花费)、地图(标明等待点之间道路连接的情况)以及对话机(用于和同组的成员联系)。当集合号吹响后,每组成员之间迅速联系,了解到自己组所有成员所在的等待点后,迅速在 $n$ 个等待点中确定一个集结点,组内所有成员将在该集合点集合,集合所用花费最少的组将是游戏的赢家。
|
||||
|
||||
小可可和他的朋友邀请你一起参加这个游戏,由你来选择集合点,聪明的你能够完成这个任务,帮助小可可赢得游戏吗?
|
||||
|
||||
## 输入格式
|
||||
|
||||
第一行两个正整数 $n$ 和 $m$,分别表示等待点的个数(等待点也从 $1$ 到 $n$ 进行编号)和获奖所需要完成集合的次数。
|
||||
|
||||
随后 $n-1$ 行,每行两个正整数 $a,b$,表示编号为 $a$ 和编号为 $b$ 的等待点之间有一条路。
|
||||
|
||||
随后 $m$ 行,每行用三个正整数 $x,y,z$,表示某次集合前小可可、小可可的朋友以及你所在等待点的编号。
|
||||
|
||||
## 输出格式
|
||||
|
||||
输出共 $m$ 行,每行两个用空格隔开的整数 $p,c$。其中第 $i$ 行表示第 $i$ 次集合点选择在编号为 $p$ 的等待点,集合总共的花费是 $c$ 个游戏币。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
6 4
|
||||
1 2
|
||||
2 3
|
||||
2 4
|
||||
4 5
|
||||
5 6
|
||||
4 5 6
|
||||
6 3 1
|
||||
2 4 4
|
||||
6 6 6
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
5 2
|
||||
2 5
|
||||
4 1
|
||||
6 0
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
对于 $40\%$ 的数据,$n\leq2\times10^3$,$m\leq2\times 10^3$。
|
||||
|
||||
对于 $100\%$ 的数据,$1\leq x,y,z\leq n\leq 5\times10^5$,$1\leq m\leq 5\times 10^5$。
|
||||
@@ -0,0 +1,85 @@
|
||||
#include<bits/stdc++.h>
|
||||
using namespace std;
|
||||
const int mod = 998244353;
|
||||
int n, m, k;
|
||||
int up;
|
||||
vector<int> fri[300005];
|
||||
int fa[3000005];
|
||||
int cnt[300005];
|
||||
int son[300005];
|
||||
int dfn[300005];
|
||||
int rev[300005];
|
||||
int top[300005];
|
||||
int dep[300005];
|
||||
int nowdfn;
|
||||
struct SEG{
|
||||
int num[51][1200005];
|
||||
void init(int now, int nl, int nr) {
|
||||
if(nl == nr) {
|
||||
num[0][now] = 1;
|
||||
for(int i = 1; i <= 50; ++i)
|
||||
num[i][now] = (1ll * num[i - 1][now] * dep[rev[nl]]) % mod;
|
||||
return;
|
||||
}
|
||||
int nmid = (nl + nr) >> 1;
|
||||
init(now * 2, nl, nmid);
|
||||
init(now * 2 + 1, nmid + 1, nr);
|
||||
for(int i = 1; i <= 50; ++i) num[i][now] = (1ll * num[i][now * 2] + num[i][now * 2 + 1]) % mod;
|
||||
}
|
||||
int query(int now, int nl, int nr, int l, int r) {
|
||||
if(nl > r || nr < l) return 0;
|
||||
if(l <= nl && nr <= r) return num[k][now];
|
||||
int nmid = (nl + nr) >> 1;
|
||||
return (1ll * query(now * 2, nl, nmid, l, r) + query(now * 2 + 1, nmid + 1, nr, l, r)) % mod;
|
||||
}
|
||||
}seg;
|
||||
void dfs1(int now, int from) {
|
||||
cnt[now] = 1;
|
||||
for(int i : fri[now]) {
|
||||
if(i == from) continue;
|
||||
fa[i] = now;
|
||||
dep[i] = dep[now] + 1;
|
||||
dfs1(i, now);
|
||||
cnt[now] += cnt[i];
|
||||
if(cnt[i] > cnt[son[now]]) son[now] = i;
|
||||
}
|
||||
}
|
||||
void dfs2(int now, int from) {
|
||||
dfn[now] = ++nowdfn;
|
||||
rev[nowdfn] = now;
|
||||
top[now] = from;
|
||||
if(son[now]) dfs2(son[now], from);
|
||||
for(int i : fri[now]) {
|
||||
if(i == fa[now] || i == son[now]) continue;
|
||||
dfs2(i, i);
|
||||
}
|
||||
}
|
||||
int query(int a, int b) {
|
||||
int ans = 0;
|
||||
while(top[a] != top[b]) {
|
||||
if(dep[top[a]] < dep[top[b]]) swap(a, b);
|
||||
ans = (ans + 1ll * seg.query(1, 1, n, dfn[top[a]], dfn[a])) % mod;
|
||||
a = fa[top[a]];
|
||||
}
|
||||
if(dep[a] < dep[b]) swap(a, b);
|
||||
ans = (ans + 1ll * seg.query(1, 1, n, dfn[b], dfn[a])) % mod;
|
||||
return ans;
|
||||
}
|
||||
int main() {
|
||||
scanf("%d", &n);
|
||||
for(int i = 1, u, v; i < n; ++i) {
|
||||
scanf("%d%d", &u, &v);
|
||||
fri[u].push_back(v);
|
||||
fri[v].push_back(u);
|
||||
}
|
||||
dfs1(1, 0);
|
||||
dfs2(1, 1);
|
||||
seg.init(1, 1, n);
|
||||
scanf("%d", &m);
|
||||
for(up = 1; up <= m; ++up) {
|
||||
int i, j;
|
||||
scanf("%d%d%d", &i, &j, &k);
|
||||
printf("%d\n", query(i, j));
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
@@ -0,0 +1,67 @@
|
||||
# P4427 [BJOI2018] 求和
|
||||
|
||||
## 题目描述
|
||||
|
||||
master 对树上的求和非常感兴趣。他生成了一棵有根树,并且希望多次询问这棵树上一段路径上所有节点深度的 $k$ 次方和,而且每次的 $k$ 可能是不同的。此处节点深度的定义是这个节点到根的路径上的边数。他把这个问题交给了 pupil,但 pupil 并不会这么复杂的操作,你能帮他解决吗?
|
||||
|
||||
## 输入格式
|
||||
|
||||
第一行包含一个正整数 $n$,表示树的节点数。
|
||||
|
||||
之后 $n-1$ 行每行两个空格隔开的正整数 $i, j$,表示树上的一条连接点 $i$ 和点 $j$ 的边。
|
||||
|
||||
之后一行一个正整数 $m$,表示询问的数量。
|
||||
|
||||
之后每行三个空格隔开的正整数 $i, j, k$,表示询问从点 $i$ 到点 $j$ 的路径上所有节点深度的 $k$ 次方和。由于这个结果可能非常大,输出其对 $998244353$ 取模的结果。
|
||||
|
||||
树的节点从 $1$ 开始标号,其中 $1$ 号节点为树的根。
|
||||
|
||||
## 输出格式
|
||||
|
||||
对于每组数据输出一行一个正整数表示取模后的结果。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
5
|
||||
1 2
|
||||
1 3
|
||||
2 4
|
||||
2 5
|
||||
2
|
||||
1 4 5
|
||||
5 4 45
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
33
|
||||
503245989
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
### 样例解释
|
||||
|
||||
以下用 $d (i)$ 表示第 $i$ 个节点的深度。
|
||||
|
||||
对于样例中的树,有 $d (1) = 0, d (2) = 1, d (3) = 1, d (4) = 2, d (5) = 2$。
|
||||
|
||||
因此第一个询问答案为 $(2^5 + 1^5 + 0^5) \bmod 998244353 = 33$,第二个询问答案为$(2^{45} + 1^{45} + 2^{45}) \bmod 998244353 = 503245989$。
|
||||
|
||||
### 数据范围
|
||||
|
||||
对于 $30\%$ 的数据,$1 \leq n,m \leq 100$。
|
||||
|
||||
对于 $60\%$ 的数据,$1 \leq n,m \leq 1000$。
|
||||
|
||||
对于 $100\%$ 的数据,$1 \leq n,m \leq 300000$,$1 \leq k \leq 50$。
|
||||
|
||||
另外存在 5 个不计分的 hack 数据。
|
||||
|
||||
### 提示
|
||||
|
||||
数据规模较大,请注意使用较快速的输入输出方式。
|
||||
@@ -0,0 +1,32 @@
|
||||
#include<bits/stdc++.h>
|
||||
#define int long long
|
||||
using namespace std;
|
||||
int n, m, s;
|
||||
int d[100005];
|
||||
vector<pair<int, int>> fri[100005];
|
||||
priority_queue<pair<int, int>, vector<pair<int, int>>, greater<pair<int, int>>> q;
|
||||
signed main() {
|
||||
scanf("%lld%lld%lld", &n, &m, &s);
|
||||
memset(d, 0x7f, sizeof d);
|
||||
d[s] = 0;
|
||||
for(int i = 1, u, v, w; i <= m; ++i) {
|
||||
scanf("%lld%lld%lld", &u, &v, &w);
|
||||
fri[u].push_back({w, v});
|
||||
}
|
||||
q.push({0, s});
|
||||
while(!q.empty()) {
|
||||
pair<int, int> now = q.top();
|
||||
q.pop();
|
||||
if (now.first != d[now.second]) continue;
|
||||
for(pair<int, int> to:fri[now.second]) {
|
||||
if(d[to.second] > d[now.second] + to.first) {
|
||||
d[to.second] = d[now.second] + to.first;
|
||||
q.push({d[to.second], to.second});
|
||||
}
|
||||
}
|
||||
}
|
||||
for(int i = 1; i <= n; ++i) {
|
||||
printf("%lld ", d[i]);
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
@@ -0,0 +1,70 @@
|
||||
# P4779 【模板】单源最短路径(标准版)
|
||||
|
||||
## 题目背景
|
||||
|
||||
2018 年 7 月 19 日,某位同学在 [NOI Day 1 T1 归程](https://www.luogu.com.cn/problem/P4768) 一题里非常熟练地使用了一个广为人知的算法求最短路。
|
||||
|
||||
然后呢?
|
||||
|
||||
$100 \rightarrow 60$;
|
||||
|
||||
$\text{Ag} \rightarrow \text{Cu}$;
|
||||
|
||||
最终,他因此没能与理想的大学达成契约。
|
||||
|
||||
小 F 衷心祝愿大家不再重蹈覆辙。
|
||||
|
||||
## 题目描述
|
||||
|
||||
给定一个 $n$ 个点,$m$ 条有向边的带非负权图,请你计算从 $s$ 出发,到每个点的距离。
|
||||
|
||||
数据保证你能从 $s$ 出发到任意点。
|
||||
|
||||
## 输入格式
|
||||
|
||||
第一行为三个正整数 $n, m, s$。
|
||||
第二行起 $m$ 行,每行三个非负整数 $u_i, v_i, w_i$,表示从 $u_i$ 到 $v_i$ 有一条权值为 $w_i$ 的有向边。
|
||||
|
||||
## 输出格式
|
||||
|
||||
输出一行 $n$ 个空格分隔的非负整数,表示 $s$ 到每个点的距离。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
4 6 1
|
||||
1 2 2
|
||||
2 3 2
|
||||
2 4 1
|
||||
1 3 5
|
||||
3 4 3
|
||||
1 4 4
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
0 2 4 3
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
样例解释请参考 [数据随机的模板题](https://www.luogu.com.cn/problem/P3371)。
|
||||
|
||||
$1 \leq n \leq 10^5$;
|
||||
|
||||
$1 \leq m \leq 2\times 10^5$;
|
||||
|
||||
$s = 1$;
|
||||
|
||||
$1 \leq u_i, v_i\leq n$;
|
||||
|
||||
$0 \leq w_i \leq 10 ^ 9$,
|
||||
|
||||
$0 \leq \sum w_i \leq 10 ^ 9$。
|
||||
|
||||
本题数据可能会持续更新,但不会重测,望周知。
|
||||
|
||||
2018.09.04 数据更新 from @zzq
|
||||
@@ -0,0 +1,33 @@
|
||||
#include<bits/stdc++.h>
|
||||
using namespace std;
|
||||
long long a;
|
||||
int minans = INT_MAX;
|
||||
int n;
|
||||
void dfs(int now, int pre_k, long long now_a) {
|
||||
if(now > 6 || now >= minans) {
|
||||
return;
|
||||
}
|
||||
if(now_a == (1ll << n) - 1) {
|
||||
minans = min(minans, now);
|
||||
}
|
||||
for(int k = pre_k; k <= n; ++k) {
|
||||
long long new_a = now_a | (now_a >> k);
|
||||
if(new_a > now_a) dfs(now + 1, k, new_a);
|
||||
}
|
||||
}
|
||||
int main() {
|
||||
char s[45];
|
||||
scanf("%s", s + 1);
|
||||
if(s[1] == '0') {
|
||||
printf("-1\n");
|
||||
return 0;
|
||||
}
|
||||
n = strlen(s + 1);
|
||||
for(int i = 1; i <= n; ++i) {
|
||||
a *= 2;
|
||||
if(s[i] == '1') a += 1;
|
||||
}
|
||||
dfs(0, 1, a);
|
||||
printf("%d\n", minans);
|
||||
return 0;
|
||||
}
|
||||
@@ -0,0 +1,55 @@
|
||||
# P7458 [CERC2018] Clockwork ||ange
|
||||
|
||||
## 题目描述
|
||||
|
||||
**译自[ [CERC2018]](https://contest.felk.cvut.cz/18cerc/) [Clockwork ||ange](https://contest.felk.cvut.cz/18cerc/solved/clockwork.pdf)**
|
||||
|
||||
据百度百科,兔是哺乳类兔形目兔科下属所有的属的总称。毋庸置疑的是,这段文字不是无聊的,因为它们是原始的,并且组织良好。我们农场的兔子生活在有保护的畜栏里,畜栏的边界装饰有精美的花卉装饰品。畜栏里生长着数十个可爱的橙色胡萝卜。兔子繁殖很快(这很正常,每年都有成千上万的兔子出生),我们的导师希望不费力地把它们安置在畜栏里。
|
||||
|
||||
畜栏规则地形成一排。在第一个繁殖季开始时,一些畜栏里可能没有兔子。每个繁殖季结束时,都会进行一次精心策划过的兔子搬迁。搬迁遵循一条简单的公式,这个公式取决于一个正整数 $K$,不同的繁殖季 $K$ 值不一定相同。对于所有畜栏,搬迁工作同时进行。在每个畜栏中,大约有一半的兔子被移到这个畜栏右边第 $K$ 个畜栏里。目标畜栏里原来有没有兔子都没有关系。
|
||||
|
||||
如果畜栏离这一排最后一个畜栏太近(即离最后一个畜栏的距离小于 $K$ ),那么这个畜栏中的所有兔子都留在原畜栏,不会进行搬迁。
|
||||
|
||||
每个畜栏都可以容纳无限只兔子,并且非空的畜栏中总有足够多能够成功繁殖的兔子。
|
||||
|
||||
给定第一个繁殖季开始时畜栏被占用的情况。请求出使得所有畜栏中都有兔子的最少搬迁次数。
|
||||
|
||||
## 输入格式
|
||||
|
||||
输入仅有一行,包含一个长度为 $b$ 的字符串,每个字符表示一个畜栏。字符只有 $0$(空畜栏)和 $1$(有兔子的畜栏)两种。第一个字符表示这一排的第一个畜栏。
|
||||
|
||||
## 输出格式
|
||||
|
||||
输出使得所有畜栏中都有兔子的最少搬迁次数。如果没有任何一种搬迁方案使得每个畜栏中都有兔子,输出 $-1$。
|
||||
|
||||
## 输入输出样例 #1
|
||||
|
||||
### 输入 #1
|
||||
|
||||
```
|
||||
1010
|
||||
```
|
||||
|
||||
### 输出 #1
|
||||
|
||||
```
|
||||
1
|
||||
```
|
||||
|
||||
## 输入输出样例 #2
|
||||
|
||||
### 输入 #2
|
||||
|
||||
```
|
||||
100110000
|
||||
```
|
||||
|
||||
### 输出 #2
|
||||
|
||||
```
|
||||
3
|
||||
```
|
||||
|
||||
## 说明/提示
|
||||
|
||||
$1≤b≤40$
|
||||
@@ -0,0 +1,70 @@
|
||||
# CSPS 2026 游记
|
||||
|
||||
华二紫竹,$2026-10-31T14:30+08:00 \sim 2026-10-31T18:30+08:00$。
|
||||
|
||||
## timeline (git commit history):
|
||||
|
||||
- 14:39 init (带 diff.sh)
|
||||
- 14:58 T1 45 pts
|
||||
- 15:26 T1 100 pts
|
||||
- 15:34 为 T1 写了 gen
|
||||
- 16:04 T2 20pts(实际 36 pts)
|
||||
- 16:15 T2 60 pts(实际 68 pts)
|
||||
- 16:19 T2 开 long long
|
||||
- 16:22 T1 对拍发现有一个变量没开 long long(感谢 diff.sh)
|
||||
- 16:50 为 T2 写了 gen(然而 gen 的数据并不保证图连通 这个考场上导致好多次误判)
|
||||
- 17:07 因为 T2 gen 的构造的数据问题导致不必要的 long long 和特判
|
||||
- 17:59 依旧卡 T2,T3 T4 毫无推进
|
||||
- (约)18:20 发现 T2 并无问题,尝试写 T3 T4 暴力,然而时间不够
|
||||
|
||||
## T1
|
||||
|
||||
最开始以为答案是关于最终相等的数单调的,想写二分,发现第二个样例证伪了这一结论。发现最终相同的数一定是 $a_i (i \in [1, n])$。
|
||||
|
||||
先写了个 [45pts 的暴力](https://git.vblg.top/hanyixuanten/csps2026/src/commit/bf08016dee210d518b187b7730a4f8f27ae47f24/crystal/crystal.cpp)。此时考试已开始 28 min。
|
||||
|
||||
考虑到使用二分 + 前缀和优化[寻找 ans 的过程](https://git.vblg.top/hanyixuanten/csps2026/src/commit/bf08016dee210d518b187b7730a4f8f27ae47f24/crystal/crystal.cpp#L12-L13)。但是因为二分出来的答案一直多 1 或少 1,就出现了[这几行代码(笑哭)](https://git.vblg.top/hanyixuanten/csps2026/src/commit/8b21377d1fa3208ef8d27b7592e91d1dbf8a40fc/crystal/crystal.cpp#L22-L23)。
|
||||
|
||||
然而,最开始的时候 [checkb 函数的 now 没开 long long](https://git.vblg.top/hanyixuanten/csps2026/src/commit/8b21377d1fa3208ef8d27b7592e91d1dbf8a40fc/crystal/crystal.cpp#L7),差点 100->65,diff.sh 立大功。
|
||||
|
||||
附 [gen.cpp](https://git.vblg.top/hanyixuanten/csps2026/src/commit/c9a42541c404d2b6395e49b9c35e4eb71109327b/crystal/gen.cpp)。
|
||||
|
||||
## T2
|
||||
|
||||
其实考试开始 34 min 就想出了[“500 条线路各视为图上的一个点,分别和地铁站连线”](https://git.vblg.top/hanyixuanten/csps2026/src/commit/64eda003fc35794e1805274785a058db89a21eeb/subway/subway.cpp#L49),但是由于无负边权,自然的想到了 dij,后续又加入了预处理优化,16:15 写完后发现并不能通过最后两个大样例(3s)。然而并没有想到 $O(n^3)$ 的 Floyd 在这种情况下更快。(写这篇记录的时候还没有正式出成绩,若 CCF 的评测机发力则可能多点分。)
|
||||
|
||||
附 [gen.cpp](https://git.vblg.top/hanyixuanten/csps2026/src/commit/e4991898d0b1585aa9d86a0737da057bd388de58/subway/gen.cpp)。注意这个 gen.cpp 生成的图不保证连通,所以如果代码输出了 inf 或是负数一般是图不连通导致,可忽略。
|
||||
|
||||
## T3 T4
|
||||
|
||||
由于死磕 T2 连暴力都没有写,血亏 20-60pts。
|
||||
|
||||
## 总结
|
||||
|
||||
1. 对拍、diff.sh 立大功。
|
||||
2. 由于随机数只会用 time(0) 作为种子,导致对拍效率大大下降,连续拍了半个小时才发现 T1 的问题。
|
||||
3. 过度的死磕 T2 导致 T3 T4 暴力没写。
|
||||
4. 对算法复杂度 (dij) 有错误估测,忽视冷门算法 (Floyd),导致 T2 100 -> 68。
|
||||
|
||||
附 diff.sh(linux,注意对拍代码均无需开文件读写):
|
||||
|
||||
```sh
|
||||
#!/bin/bash
|
||||
|
||||
g++ sol1.cpp -o sol1 -O2 -std=c++14 -static
|
||||
g++ sol2.cpp -o sol2 -O2 -std=c++14 -static
|
||||
g++ gen.cpp -o gen -O3 -std=c++14 -static
|
||||
for i in {1..10000}; do
|
||||
gen > in
|
||||
sol1 < in > a
|
||||
sol2 < in > b
|
||||
if ! diff -q a b > /dev/null; then
|
||||
echo wa
|
||||
cp in wa.in
|
||||
cp a wa1.out
|
||||
cp b wa2.out
|
||||
break
|
||||
fi
|
||||
echo success $i
|
||||
done
|
||||
```
|
||||
@@ -0,0 +1,106 @@
|
||||
# CF1380D Berserk And Fireball 题解
|
||||
|
||||
> 考场上没有看见 $a_i$ 两两不同,卡了半天。
|
||||
|
||||
下文用“$k$ 删除”代表“火球术”,用“单点删除”代表“狂暴术”。
|
||||
|
||||
先判断是运行一次 $k$ 删除更优或者运行 $k$ 次单点删除更优。
|
||||
|
||||
由于 $a_i$ 两两不同,显然可以使用一个 `map` 保存 $a_i$ 所在的位置 $index_{a_i}$。
|
||||
|
||||
对于每对 $b_{i - 1}, b_i$,得到区间 $[index_{b_{i - 1}}, index_{b_i}]$ (其中 $index_0 = 0$),设 $len = index_{b_i} - index_{b_{i - 1}} - 1$。然后分类讨论:
|
||||
|
||||
- 若 $k$ 删除更优,可以先运行 $len \% k$ 次单点删除,然后运行 $\lfloor \frac{len}{k} \rfloor$ 次 $k$ 删除。
|
||||
- 若单点删除更优:
|
||||
- 若区间内有数 $a_i > \max{(a_{index_{b_{i - 1}}}, a_{index_{b_i}})}$,则必须运行一次 $k$ 删除来移除这个数,因此先运行 $len - k$ 次单点删除,最后运行一次 $k$ 删除。
|
||||
- 否则,可以直接运行 $len$ 次单点删除。
|
||||
|
||||
由此我们就可以得到无解条件:区间内有大于两边的数且区间长度 $< k$,或 $index_{b_{i - 1}} > index_{b_i}$。
|
||||
|
||||
注意不要忘了处理最后一个区间。
|
||||
|
||||
::::success[code]
|
||||
|
||||
```cpp
|
||||
#include <bits/stdc++.h>
|
||||
using namespace std;
|
||||
int n, m, k;
|
||||
long long x, y;
|
||||
int a[200005];
|
||||
int b, preb;
|
||||
int pos[200005];
|
||||
bool k_is_better;
|
||||
vector<int> mor;
|
||||
long long del(int pre, int todo)
|
||||
{
|
||||
if (todo <= pre)
|
||||
return -1;
|
||||
if (todo == pre + 1)
|
||||
return 0;
|
||||
mor.clear();
|
||||
for (int j = pre + 1; j <= todo - 1; ++j)
|
||||
if (a[j] > max(a[todo], a[pre]))
|
||||
mor.push_back(j);
|
||||
if (!mor.empty() && (todo - pre - 1) < k) // 如果有大数且长度不足以运行一次 k 则不存在
|
||||
return -1;
|
||||
if (k_is_better)
|
||||
{
|
||||
return ((todo - pre - 1) % k) * y + ((todo - pre - 1) / k) * x; // 先用 y 移除多余的数,最后用多个 k 直接删完
|
||||
}
|
||||
else
|
||||
{
|
||||
if (!mor.empty())
|
||||
return (todo - pre - 1 - k) * y + x; // 用一次k清除最大数,其余用y
|
||||
else
|
||||
return (todo - pre - 1) * y; // 全部用y
|
||||
}
|
||||
return 0;
|
||||
}
|
||||
int main()
|
||||
{
|
||||
scanf("%d%d%lld%d%lld", &n, &m, &x, &k, &y);
|
||||
k_is_better = x < (k * y);
|
||||
for (int i = 1; i <= n; ++i)
|
||||
{
|
||||
scanf("%d", &a[i]);
|
||||
pos[a[i]] = i;
|
||||
}
|
||||
long long ans = 0;
|
||||
for (int i = 1; i <= m; ++i)
|
||||
{
|
||||
scanf("%d", &b);
|
||||
int todo = pos[b], pre = 0;
|
||||
if (i != 1)
|
||||
pre = pos[preb];
|
||||
long long d = del(pre, todo);
|
||||
if (d == -1ll)
|
||||
{
|
||||
printf("-1\n");
|
||||
return 0;
|
||||
}
|
||||
ans += d;
|
||||
preb = b;
|
||||
}
|
||||
long long d = del(pos[b], n + 1);
|
||||
if (d == -1ll)
|
||||
{
|
||||
printf("-1\n");
|
||||
return 0;
|
||||
}
|
||||
printf("%lld\n", ans + d);
|
||||
return 0;
|
||||
}
|
||||
/*
|
||||
若 k 删除更优,先删到能被 k 整除的长度,则先 k 删除,最后运行多次 k 删除
|
||||
len % k
|
||||
若 1 删除更优,先用 k 删除删去大于两边的,最后用 1 删除
|
||||
7 2
|
||||
3 3 1
|
||||
5 7 0 3 1 6 4
|
||||
5 4
|
||||
|
||||
输出 5
|
||||
*/
|
||||
```
|
||||
|
||||
::::
|
||||
+2
-2
@@ -2,6 +2,6 @@
|
||||
|
||||
题意可转化为有一棵树,每个节点有权值,一个边两端的点不能同时去,同时 $S, T$ 也不能同时取(断开环上的两个点)。
|
||||
|
||||
因此可转化两次为[P1352 没有上司的舞会](https://www.luogu.com.cn/problem/P1352#),设 $f_{i, 01}$ 以 $i$ 为根的子树,是否选择本节点的收益,只需[以 $S$ 为根时令 $f_{T, 1} = -\inf$,以 $T$ 为根时令 $f_{S, 1} = -\inf$ 即可。](../P1453.cpp#L17-19)
|
||||
因此可转化两次为[P1352 没有上司的舞会](https://www.luogu.com.cn/problem/P1352#),设 $f_{i, 01}$ 以 $i$ 为根的子树,是否选择本节点的收益,只需[以 $S$ 为根时令 $f_{T, 1} = -\inf$,以 $T$ 为根时令 $f_{S, 1} = -\inf$ 即可。](../P1453.cpp#L17-L18)
|
||||
|
||||
[code](../P1453.cpp)
|
||||
[code](../P1453.cpp)
|
||||
+1
-1
@@ -6,6 +6,6 @@
|
||||
|
||||
本题与[P1453](../P1453.md)的区别是形成的不只是一个树+断边,而是一个森林+断边。
|
||||
|
||||
只需要将 [P1453 的并查集](../P1453.cpp#L35-42)改为[保存 $S, T$ vector](../P2607.cpp#L33-40),随后对于每个树+断边仿照 P1453 的实现即可
|
||||
只需要将 [P1453 的并查集](../P1453.cpp#L35-L41)改为[保存 $S, T$ vector](../P2607.cpp#L33-L39),随后对于每个树+断边仿照 P1453 的实现即可
|
||||
|
||||
[code](../P2607.cpp)
|
||||
@@ -0,0 +1,16 @@
|
||||
# P3384 【模板】重链剖分 / 树链剖分 题解
|
||||
|
||||
重链剖分模板。习惯用线段树(也可以双 BIT)。
|
||||
|
||||
其中:
|
||||
|
||||
- [L13-48](../P3384.cpp#L13-L48) 为维护区间和的线段树。
|
||||
- [L49-59](../P3384.cpp#L49-L59) 为 dfs1,处理 $dep, cnt, fa, son$。
|
||||
- [L60-71](../P3384.cpp#L60-L71) 为 dfs2,处理 $dfn, top$。
|
||||
- [L72-80](../P3384.cpp#L72-L80) 为路径加,上跳即可。
|
||||
- [L81-90](../P3384.cpp#L81-L90) 为路径查询,与修改是类似的。
|
||||
- [L91-96](../P3384.cpp#L91-L96) 为子树修改与查询,由于子树的 $dfn$ 序列是连续的,直接在线段树上修改即可。
|
||||
|
||||
接下来建议用树链剖分解决一些[简单题](https://www.luogu.com.cn/problem/list?type=luogu&page=1&tag=228&orderBy=difficulty&order=asc)。
|
||||
|
||||
[code](../P3384.cpp)
|
||||
@@ -0,0 +1,17 @@
|
||||
# P4211 [LNOI2014] LCA 题解
|
||||
|
||||
给定一棵树,对于每个给定的 $l, r, z$,求:
|
||||
|
||||
$$\sum_{i = l}^r dep[\operatorname{LCA}(i, z)]$$
|
||||
|
||||
考虑转化。$dep[\operatorname{LCA}(x, y)]$ 表示从根节点到 $\operatorname{LCA}(x, y)$ 节点经过的节点数,其相当于对于根节点到 $x$ 的路径上每个点都 $+ 1$,求从根节点到 $y$ 的路径上所有节点的权值和。
|
||||
|
||||
因此,考虑使用树链剖分,对于每次操作,对 $root \rightarrow i, i \in [l, r]$ 的路径上每个点权值 $+ 1$,并求 $root \rightarrow z$ 的路径上所有节点的权值和。
|
||||
|
||||
然后,很自然地,可以分别计算 $l - 1, r$ 时的答案,并维护差分求解。
|
||||
|
||||
但是,若是每次操作都清除线段树,显然有点浪费。考虑将询问离线为 $2 \times m$ 次 $[1, l - 1 \text{or } r]$ 时的查询,按照右端点排序求解。
|
||||
|
||||
总时间复杂度 $\operatorname O(n \log^2 n)$
|
||||
|
||||
[code](../P4211.cpp)
|
||||
@@ -0,0 +1,77 @@
|
||||
# P7458 [CERC2018] Clockwork ||ange 题解
|
||||
|
||||
## 二进制表示
|
||||
|
||||
我们只关心每个畜栏是否非空,因此可以用一个二进制数表示整个畜栏状态。
|
||||
|
||||
一次搬迁选择正整数 $K$,在二进制表示中,“右边第 $K$ 个畜栏”正好对应右移 $K$ 位。因此一次操作可以写成 $newa = nowa \mid (nowa \gg K)$。其中:
|
||||
|
||||
- $nowa$ 保留原来的非空畜栏。
|
||||
- $nowa \gg K$ 把兔子移动到右边第 $K$ 个畜栏。
|
||||
- 按位或表示合并新旧状态。
|
||||
|
||||
如果某个畜栏离最后一个畜栏太近,右移后越界,越界部分自然消失;而原畜栏仍然保留,所以正好符合题目“太靠右则全部留在原畜栏”的规则。
|
||||
|
||||
## DFS 搜索
|
||||
|
||||
设当前状态为 $nowa$,已经进行了 $now$ 次搬迁,上一次选择的 $K$ 为 $pre_k$。
|
||||
|
||||
由于每次操作都是“并上右移后的结果”,操作顺序实际上可以交换。因此我们可以限制选择的 $K$ 非降,避免重复枚举同一种操作序列。
|
||||
|
||||
其中 $newa > nowa$ 用来剪掉没有产生任何新非空畜栏的操作。因为所有可达状态都包含初始状态 $a$,所以 $newa > nowa$ 等价于“至少新增了一个初始为空的畜栏”。如果一次操作没有新增任何畜栏,它不会帮助达到目标,可以跳过。
|
||||
|
||||
如果:
|
||||
|
||||
```cpp
|
||||
now_a == (1ll << n) - 1
|
||||
```
|
||||
|
||||
说明所有 $n$ 个畜栏都非空,更新答案。
|
||||
|
||||
## 为什么最多只需要 6 次
|
||||
|
||||
如果第一个畜栏有兔子,那么可以依次选择 $K = 1, 2, 4, 8, 16, 32$。
|
||||
|
||||
不难发现,只要第一个畜栏有兔子,六次操作一定可以填满。
|
||||
|
||||
## 参考代码
|
||||
|
||||
::::success[code]
|
||||
|
||||
```cpp
|
||||
#include<bits/stdc++.h>
|
||||
using namespace std;
|
||||
long long a;
|
||||
int minans = INT_MAX;
|
||||
int n;
|
||||
void dfs(int now, int pre_k, long long now_a) {
|
||||
if(now > 6 || now >= minans) {
|
||||
return;
|
||||
}
|
||||
if(now_a == (1ll << n) - 1) {
|
||||
minans = min(minans, now);
|
||||
}
|
||||
for(int k = pre_k; k <= n; ++k) {
|
||||
long long new_a = now_a | (now_a >> k);
|
||||
if(new_a > now_a) dfs(now + 1, k, new_a);
|
||||
}
|
||||
}
|
||||
int main() {
|
||||
char s[45];
|
||||
scanf("%s", s + 1);
|
||||
if(s[1] == '0') {
|
||||
printf("-1\n");
|
||||
return 0;
|
||||
}
|
||||
n = strlen(s + 1);
|
||||
for(int i = 1; i <= n; ++i) {
|
||||
a *= 2;
|
||||
if(s[i] == '1') a += 1;
|
||||
}
|
||||
dfs(0, 1, a);
|
||||
printf("%d\n", minans);
|
||||
return 0;
|
||||
}
|
||||
```
|
||||
|
||||
::::
|
||||
Reference in new issue
Block a user